Sieben Wörter und ein gutes Issue

implement #201

Das ist der ganze Prompt. Zwei Wörter, kleingeschrieben, kein Punkt, kein Bitte. Was der Agent wissen muss, steht nicht darin, sondern in Issue #201, das ich vorher mit meinem /create-issue-Skill angelegt habe. Der Prompt ist nur der Zeiger. Die eigentliche Arbeit steckt im Issue.

Im Mai habe ich hier gefragt, wie ihr eigentlich mit euren KI-Agenten redet: kurz und direkt wie ein CLI-Kommando oder ausführlich wie eine Nachricht an einen Kollegen. Jetzt habe ich nachgeschaut, wie ich es selbst mache. Nicht aus dem Bauch heraus, sondern anhand meiner eigenen Historie.

Die Zahlen

Grundlage sind rund 1.270 echte Prompts an Claude Code von Februar bis November 2026, verteilt auf etwa 20 Projekte. 83 % davon habe ich nach 16 Uhr geschrieben. Es geht also vor allem um private Feierabendprojekte.
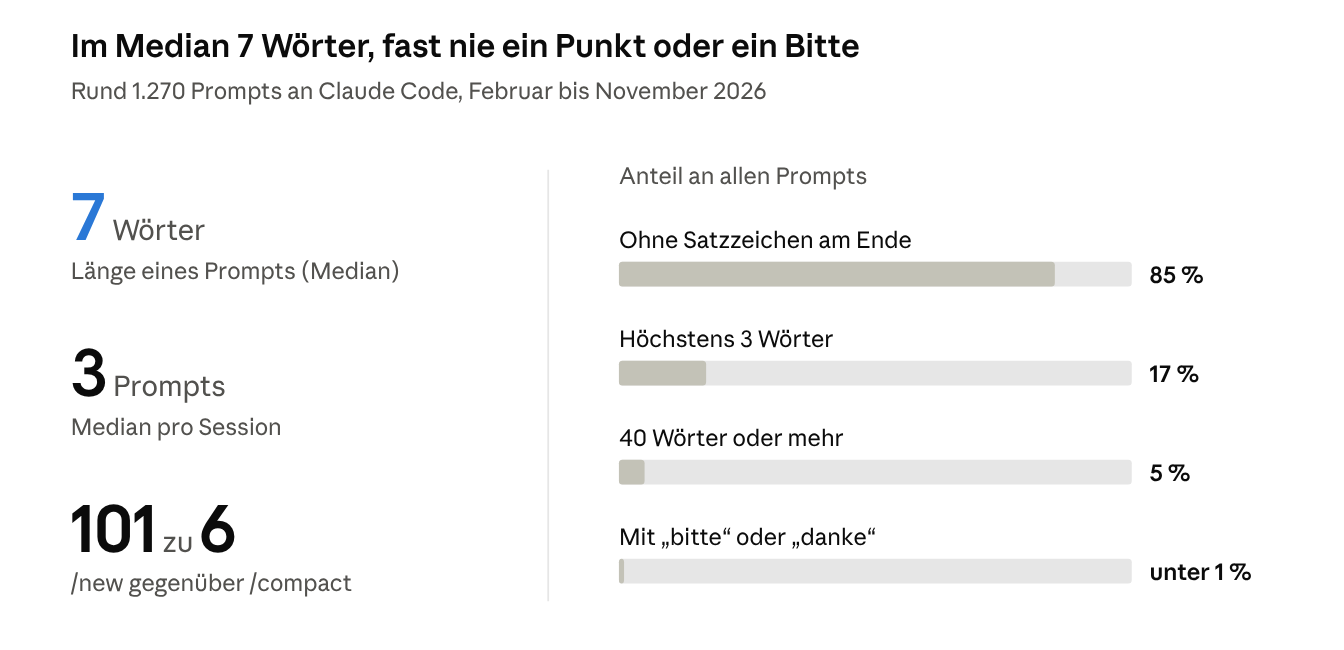
Grafik zu meinen Prompts an Claude Code: im Median 7 Wörter pro Prompt und 3 Prompts pro Session, 101-mal /new gegenüber 6-mal /compact. Anteil an allen Prompts: 85 % ohne Satzzeichen am Ende, 17 % mit höchstens 3 Wörtern, 5 % mit 40 Wörtern oder mehr, unter 1 % mit bitte oder danke.
Eigene Prompt-Historie: rund 1.270 Prompts von Februar bis November 2026

Man könnte meinen, ich sei einfach schreibfaul geworden. Ich sehe das anders: Der Aufwand steckt nicht im Prompt, er passiert vorher. Die Kunst liegt für mich nicht mehr im geschickten Prompt, sondern darin, gute Issues, Skills und Tests einmal zu schreiben. Dann schrumpft der Prompt für die einzelne Aufgabe auf einen Zeiger und ein Verb. Und ich traue dem Agenten Schritt für Schritt mehr zu.

Sechs Muster, die immer wieder auftauchen

Zeiger statt Spezifikation. So sehen viele meiner Prompts aus:

implement #201
fix #179 this is important

Mehr steht da nicht. Die Details liegen im GitHub-Issue. Lang werden meine Prompts nur, wenn ich etwas festlege: eine User Story, einen Plan. Die Umsetzung danach ist fast immer ein Einzeiler. Für mich funktioniert das, weil das Issue einmal ordentlich geschrieben wird, nachlesbar bleibt und für die nächste Session genauso gilt wie für diese.

Teamwork makes the dream work. In 15 % meiner Prompts schreibe ich „we“ oder „let us“. Damit leite ich gemeinsames Arbeiten mit dem Agenten ein, im Chat oder im Interview-Modus, zum Planen und zur Fehlersuche. Auch hier geht es um eine klare Ansage, was passieren soll. Rund 5 % meiner Prompts beginnen mit „plan…“, „look at…“ oder „investigate…“. Manche Themen haben noch so viele Unbekannte, dass ich selbst nicht genau weiß, was ich konkret verlangen soll. Dann soll der Agent zuerst die Fragen herausarbeiten, die sich aus der Aufgabe ergeben:

determine the questions via an interview

Befunde statt Diagnosen. Die langen Prompts sind meistens gar keine langen Anweisungen. Ich kopiere etwas hinein, einen Stacktrace oder eine Warnung aus dem Store, und schreibe einen kurzen Satz davor. Typisch ist so etwas wie:

fix the AuthModal not disappearing: <stack>

Bei Hardware ist es genauso, nur bin ich dann selbst der Stacktrace. Etwa 8,5 % meiner Prompts drehen sich um Geräte, SSH, adb oder Flashen. Dort schreibe ich, was passiert ist und was ich erwartet hätte:

i pushed the button shortly and it turned off. i expected it to switch zoom level

Keine Vermutung, woran es liegen könnte. Mit einer eigenen Diagnose würde ich den Agenten eher in eine Richtung schieben, die vielleicht gar nicht stimmt. Die Beobachtung dagegen kann er nicht selbst machen.

Erst die Tests, damit ich nicht testen muss. So steht es dann auch im Prompt:

start with e2e to not have me doing all the testing

Der Satz erklärt sich fast von selbst. Tests gibt es bei mir vor allem, damit ich nicht nach jeder Änderung alles von Hand durchprobieren muss. Und sie sind die Grundlage für das nächste Muster.

Ketten statt Einzelschritte. 21 % meiner Prompts nennen einen Git- oder Release-Schritt, 52 Prompts reihen sogar drei oder mehr aneinander:

commit, pr, wait for ci, merge and make 0.6.2

Was ich abgebe, ist mit der Zeit mehr geworden. Im Juli hieß es noch „make a PR“. Im August kamen CI, Merge und Tag in einer Kette dazu. Im November dann:

I allow merging, do #415-#419 now and wait for #420

Jede neue Stufe steht auf CI und Tests. Die Freigabe bleibt trotzdem bei mir. Ich spreche sie nur ausdrücklicher aus.

Kurze Sessions, kurze Antworten. Eine Session hat bei mir im Median drei Prompts. 101-mal habe ich /new getippt, sechsmal /compact. Meistens endet eine Session mit Commit, Pull Request, Merge und danach /new. Zwischendurch reichen wenige Worte: Etwa 14 % meiner Prompts sind „yes“, „ok“, „continue“ oder „yes start as proposed“. Ausdrücklich negatives Feedback steht nur in etwa 3 % meiner Prompts. Dann schreibe ich nicht nur „falsch“, sondern beschreibe, wie es sein soll:

this is not what I want. during start, the app shows the icon in fullscreen...

Lange Sessions brauche ich nicht, weil die Regeln nicht im Verlauf stehen, sondern in Skills, in der CLAUDE.md und im Memory. Die gelten in jeder neuen Session wieder.

Damals und heute

Im Mai habe ich zwei Stile gegenübergestellt und wollte beide ausprobieren. Rückblickend war die Frage schief gestellt.

  • Damals: kurz oder mit Kontext. Heute: kurz, weil der Kontext schon da ist. Er steht im Issue, im Skill, im Test. Weggefallen ist er nicht, er ist nur umgezogen.
  • Damals: „Ich glaube nicht, dass es die eine richtige Art gibt.“ Heute: Das gilt weiterhin. Beim Festlegen wird es lang, beim Umsetzen bleibt es kurz. User Stories sind heute genau die Stelle, an der meine Prompts noch ausführlich werden.
  • Damals: Bitte und Danke habe ich als Teil des Kollegen-Stils beschrieben. Heute: Die stehen in weniger als 1 % meiner Prompts.
  • Damals: Wir lassen unsere Art, mit den Werkzeugen zu reden, auf dem Stand, auf dem wir sie kennengelernt haben. Heute: Bei mir hat sie sich deutlich verändert, aber nicht durch bessere Formulierungen. Von Februar bis Juni habe ich lange Feature-Beschreibungen geschrieben und oft erst einen Plan verlangt. Im Juli und August kamen Issue-Nummern und Release-Ketten. Im September und Oktober hat Claude echte Geräte geflasht und bedient. Im November habe ich so viel abgegeben wie nie zuvor. Den Beitrag im Mai habe ich also mitten in der Phase der langen Prompts geschrieben.
  • Damals: Ich wollte zählen, wie viele Iterationen ich brauche. Heute: drei Prompts pro Session im Median. Ob das an guten Ergebnissen liegt oder daran, dass ich nach jedem Merge neu anfange, verraten die Zahlen nicht.

Wo es hakt und was ich weiter selbst mache

Ein Hinweis ist nur so gut wie das, worauf er zeigt. Ist das Issue dünn, wird „implement #201“ nicht besser, nur schneller.

Drei Dinge bleiben bei mir Handarbeit:

  • Die Freigabe zum Mergen. Auch im November schreibe ich ausdrücklich hin, was gemergt werden darf. Das ist für mich keine Formalität, sondern die Stelle, an der die Verantwortung bei mir bleibt. Viele Issues sind so klein, dass die CI die gesamte Funktion abdeckt. Bei größeren Themen behalte ich mir vor, den Schalter selbst umzulegen, nachdem ich das Ergebnis in der Hand hatte.
  • Das Testen am echten Gerät. Claude kann flashen und Geräte über adb oder SSH selbst bedienen. Den Knopf drücke aber ich, und ich sehe, was danach passiert.
  • Rohdaten herüberholen. Stacktraces und Warnungen aus dem Store kopiere ich von Hand in den Prompt. Da bin ich die Schnittstelle zwischen zwei Systemen, die nichts voneinander wissen.

Noch etwas ist mir aufgefallen: Ich schreibe fast immer Englisch. Deutsch taucht bei Produkttexten auf, bei Betriebsthemen und dann, wenn ich etwas ganz genau erklären will oder genervt bin.

Was ihr morgen ausprobieren könnt

Das sind meine Gewohnheiten, keine Regeln für alle. Wer etwas davon ausprobieren will:

  1. Schreibt die Anforderung einmal in ein Issue und gebt im Prompt nur noch Nummer und Verb mit, etwa „implement #201“.
  2. Fügt Fehlermeldungen und Stacktraces ungekürzt ein, statt sie zusammenzufassen. Bei Hardware: was passiert ist und was ihr erwartet habt, ohne eigene Diagnose.
  3. Lasst zuerst Tests für das schreiben, was ihr sonst von Hand durchklicken würdet. Und prüft die Tests selbst: Wenn neue Tests grün sind, schaut euch das Ergebnis an. Ist es wirklich das, was ihr erwartet habt?
  4. Gebt den Auftrag in Stufen ab: erst nur den PR, dann PR mit CI, dann Merge mit ausdrücklicher Freigabe.
  5. Legt Regeln in CLAUDE.md, Skills oder Memory ab und startet für jede Aufgabe eine neue Session.

Und wie sieht das bei euch inzwischen aus?

Was diese Zahlen nicht zeigen

Die Auswertung umfasst nur meine Seite des Gesprächs. Sie sagt nichts darüber, wie gut die Ergebnisse waren, wie viel ich nacharbeiten musste oder ob längere Prompts bessere Ergebnisse gebracht hätten. Dass ich kurz schreibe, heißt erst einmal nur, dass ich kurz schreibe. Eines hat sich trotzdem gezeigt: Mit ein, zwei Sessions nach Feierabend und am Wochenende bekomme ich viel umgesetzt, ohne mein Tokenlimit bei Claude Pro auch nur annähernd auszureizen.
SmartHashtag nach 68 Releases

TLDR: Angefangen hat es mit dem Akkustand in Home Assistant. Heute hupt, lüftet und entriegelt SmartHashtag das Auto. Ein Blick zurück auf knapp drei Jahre und 68 Releases.

Anfang November habe ich Version 0.12.1 von SmartHashtag veröffentlicht. Das ist meine Home-Assistant-Integration für den Smart #1, #3 und inzwischen auch den #5. Es ist das 68. Release, und das erste Commit ist noch keine drei Jahre alt. Zeit, einmal zurückzuschauen, wie das Projekt dahin gekommen ist.

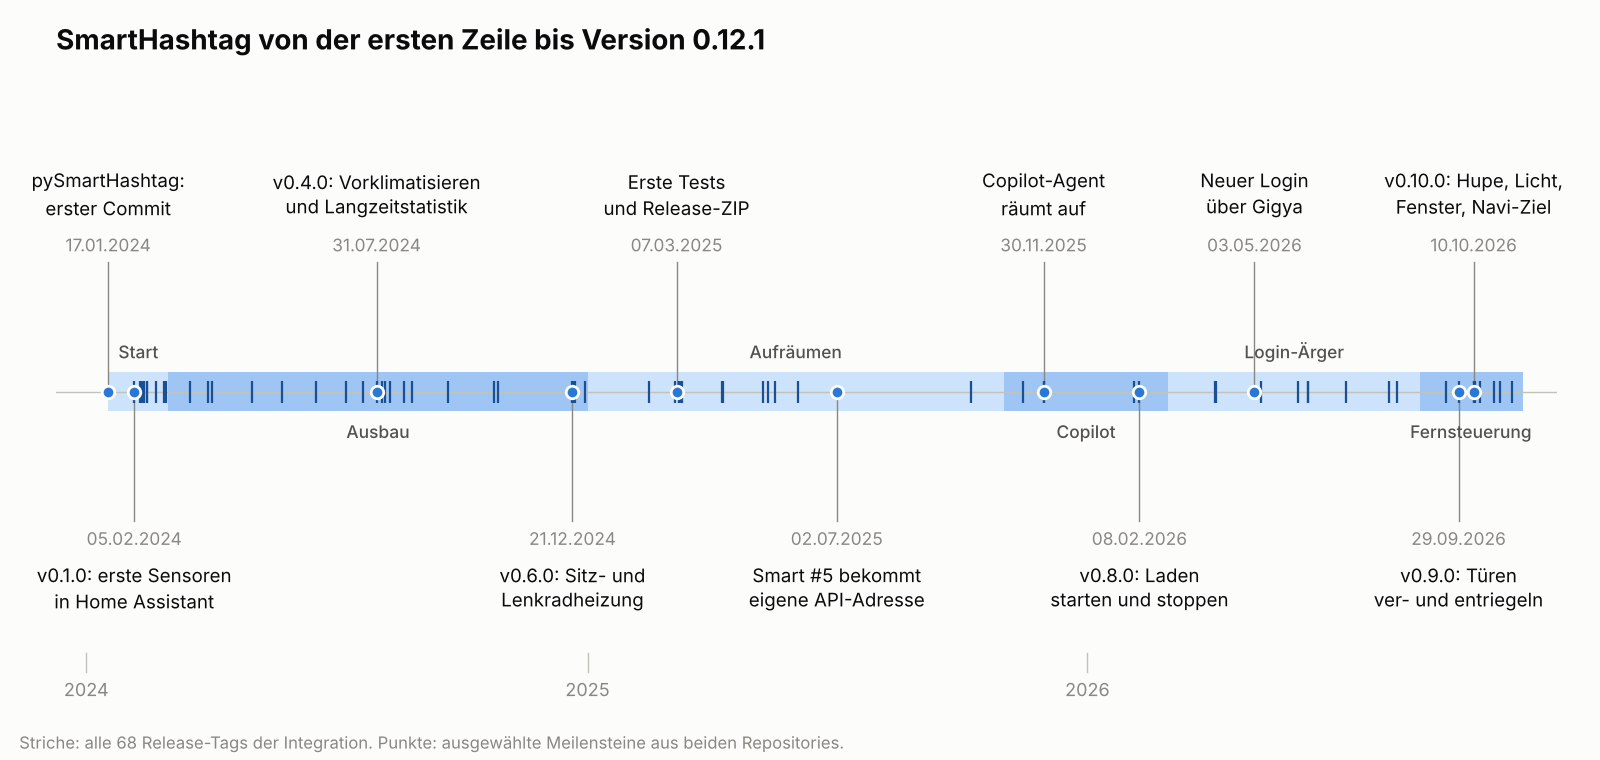
Zeitstrahl von SmartHashtag von Januar 2024 bis November 2026 mit 68 Release-Tags und elf Meilensteinen
Alle 68 Release-Tags von SmartHashtag auf einer Linie, dazu die wichtigsten Meilensteine aus Integration und Bibliothek.

Ein Leerzeichen zu viel

Angefangen hat alles nicht in Home Assistant, sondern mit der Bibliothek pySmartHashtag. Das Repository habe ich am 17. Januar 2024 angelegt. Der Name kommt von den Autos selbst: Smart nennt seine Modelle #1, #3 und #5, also Hashtag. Eine offizielle Schnittstelle gibt es nicht, nur die Cloud hinter der Smart-App. Als Vorlage hatte ich eine funktionierende Umsetzung in JavaScript, die zumindest einen Login nachspielen konnte.

Die Commit-Nachrichten aus diesen Tagen lesen sich wie ein Tagebuch. Am 18. Januar klappt der Login, aber die API antwortet mit „The access token is invalid“. Kurz danach kommt „The inspection date has expired“, immerhin eine neue Fehlermeldung. Am 19. Januar steht „fix the timestamp and now it works!“ im Log, am 22. Januar wieder „still getting access token invalid“.

Am Abend des 23. Januar hatte ich dann die beiden Ursachen gefunden. Die erste war ein Leerzeichen. Jede Anfrage an die Cloud wird über den Body signiert, und Python schreibt mit json.dumps nach jedem Doppelpunkt ein Leerzeichen, JavaScript mit JSON.stringify nicht. Erst als der Body Zeichen für Zeichen so aussah wie bei der Vorlage, hat die Cloud den Token angenommen. Die zweite war die Auth-Funktion im httpx-Client, die sich in den Login eingemischt hat. Um 22:36 Uhr steht dann „Get all vehicle information“ im Log.

125 Commits im Februar

Am 4. Februar 2024 kam das erste Commit für die Integration, einen Tag später war v0.1.0 draußen. Devcontainer, Linting und Release-Drafter waren von Anfang an dabei. Im Februar kamen 125 Commits zusammen: mehrere Autos in einem Konto mit Auswahl über die VIN, die Anmeldemaske auf Deutsch und Englisch, die 12-V-Batterie, Fahrdaten, das Auto als Device Tracker auf der Karte und ein erster Versuch, die Klimaanlage aus Home Assistant zu starten.

Außerdem passt die Integration seitdem ihr Abfrageintervall an: Beim Laden und während der Fahrt fragt sie öfter nach als im Stand. Dieses Prinzip gibt es bis heute, und es hat mir noch vor ein paar Tagen Arbeit gemacht. Dazu weiter unten mehr.

Was im Alltag fehlt

Der Rest von 2024 war Alltag: Issues lesen, Einheiten korrigieren, fehlende Werte nachziehen. Das Vorklimatisieren hat erst im Juli richtig funktioniert. Seit v0.4.0 Ende Juli landen Kilometerstand und Tageszähler in der Langzeitstatistik von Home Assistant. Im August kam DC-Laden dazu, bei dem die Cloud andere Werte liefert als beim Laden an der Wallbox. Kurz vor Weihnachten folgte v0.6.0 mit Sitz- und Lenkradheizung. Die gewählten Heizstufen speichert die Integration selbst, weil sich die Bibliothek nichts merkt.

Im September habe ich ins README geschrieben, wie man die Daten an A Better Route Planner (ABRP) schickt. Im Oktober kam dazu der erste Beitrag von außen, von Christian Gonzalvez (chriscatuk). Christian ist geblieben und hat später einige der kniffligsten Stellen beim Login übernommen.

Erst Tests, dann Funkstille

Im März 2025 hat das Projekt endlich Tests bekommen. Vorher gab es keine einzige Testdatei. Dazu kamen Regeln für Commit-Nachrichten, Ruff als Linter und ein Workflow, der an jedes Release ein ZIP hängt. Im April folgten Binärsensoren für Türen und Verriegelung, im Mai v0.7.0.

Danach wurde es ruhig. Im dritten Quartal 2025 stehen in beiden Repositories zusammen gerade einmal 18 Commits. Einer davon war trotzdem wichtig: Seit Juli wählt die Bibliothek die API-Adresse nach der Baureihe aus. Der Smart #1 und der #3 sprechen mit der alten API, der #5 mit einer neuen.

Der Copilot-Agent räumt auf

Ende November 2025 habe ich zum ersten Mal den Coding-Agent von GitHub Copilot an das Projekt gelassen. Allein am 30. November kam eine ganze Reihe von Pull Requests zusammen. Ein schönes Beispiel: Die gewählten Heizstufen gingen nach jedem Neustart von Home Assistant verloren. Die Integration hat ein Enum als Schlüssel im Dictionary benutzt, und das übersteht den Weg nach JSON und zurück nicht. Seitdem baut außerdem ein Workflow die Releases und setzt die Versionsnummer selbst.

Im Dezember hat der Agent Tests nachgezogen, aus gut 500 Zeilen Testcode wurden über 2000. Nicht alles hat gepasst. Die Unterstützung für die internationale Smart-App in Australien und Asien habe ich im Februar in der Bibliothek wieder zurückgenommen. Mit v0.8.0 im Februar 2026 kann Home Assistant das Laden starten und stoppen. Und die Sensoren bleiben verfügbar, wenn die Cloud ein paar Abfragen lang nicht antwortet, statt sofort auf „nicht verfügbar“ zu springen.

Wenn die Cloud nicht mitspielt

2026 hat mich vor allem die Cloud beschäftigt. SensorsIot hat im Frühjahr einen Backoff beigesteuert, damit sich die Bibliothek wieder fängt, wenn die Web Application Firewall nach zu vielen Anfragen dichtmacht. Seit Mai baut die Bibliothek vor dem Login eine Sitzung bei Gigya auf anstatt manuell ein Sessiontoken zusammenzubasteln. Im Juni kamen trotzdem Berichte über fehlgeschlagene Anmeldungen, die pySmartHashtag 0.9.1 behoben hat.

Christian hat im Sommer neu geregelt, wie die Bibliothek mit abgelaufenen Tokens umgeht: erst auffrischen, dann neu binden und nur, wenn gar nichts mehr geht, neu anmelden. Vorher konnte eine kurze Störung eine ganze Welle von Logins auslösen. Dazu gehört der Fehlercode 8040, den die Cloud schickt, wenn ein Auto nicht mehr mit dem Konto verknüpft ist. Home Assistant fragt dann nach neuen Zugangsdaten, statt es endlos weiter zu versuchen. Kurz danach haben wir gelernt, dass ein einzelnes 8040 noch nichts heißen muss.

Mein Lieblingsfund aus dieser Zeit: Seit Juni 2024 gab es einen Sensor für die durchschnittliche Leistungsaufnahme, mit Watt als Einheit und umgedrehtem Vorzeichen. Zwei Jahre später stellte sich in Issue #436 heraus, dass der Wert gar keine Leistung ist, sondern ein Korrekturfaktor für die Reichweite in Prozent.

Auch sonst kam mehr aus der Community. Fábio Oliveira hat die ABRP-Anleitung repariert, Jusii hat der Bibliothek das Fahrtenbuch mit GPS-Punkten beigebracht.

Vom Sensor zur Fernbedienung

Seit dem Spätsommer arbeite ich mit Claude Code an dem Projekt. Im September kamen ein Schalter zum Enteisen der Frontscheibe und das Ver- und Entriegeln der Türen dazu. Den Kofferraum wollte ich gleich mitnehmen. Die Cloud hat die Befehle zum Öffnen und Schließen zwar angenommen, die Heckklappe hat sich beim Test aber keinen Millimeter bewegt. Zwei Tage später war die Funktion wieder draußen.

Am 10. Oktober habe ich sieben Pull Requests an einem Tag gemergt. Sechs davon machen aus der Integration eine Fernbedienung: Ladelimit setzen, Kofferraum ver- und entriegeln, Fenster zum Lüften öffnen, das Sonnenrollo bewegen, Licht blinken lassen und hupen, ein Ziel ans Navi schicken und sogar einen geteilten Link aus Google Maps. Der siebte bringt die Sitzbelüftung für den Smart #5. Der Link aus Google Maps hatte einen netten Haken. Aus der EU leitet Google zuerst auf die Seite zur Cookie-Zustimmung um, und die eigentliche Maps-Adresse steckt dort in einem Parameter. Ohne den auszupacken, fand der Parser keine Koordinaten.

Bei der Sitzheizung im Smart #5 kam die entscheidende Hilfe aus der Community. Der #5 erwartet dafür ein eigenes Format, im Code heißt es ZAF. radzatm hat die funktionierende Anfrage der App mit einem Man-in-the-Middle-Proxy mitgeschnitten, ooooli hat das Format für Klima, Sitz- und Lenkradheizung dokumentiert, und krlimi69 hat die Testversionen auf einem #5 Brabus ausprobiert. Inzwischen kann die Integration beim #5 auch die Rücksitze heizen und die elektrische Ladeklappe öffnen und schließen.

Damit Tester nicht jedes Mal ZIP-Dateien von Hand installieren müssen, steht im Repository ein kleiner Trick: In Home Assistant die Aktion update.install auf die Update-Entität der Integration anwenden und als Version den kurzen Commit-Hash angeben. HACS installiert dann genau diesen Stand.

Und dann ist da noch v0.12.1 vom 7. November. Wer sich zu oft mit einem falschen Passwort anmeldet, wird bei Gigya gesperrt, und die Bibliothek hat es bisher trotzdem stur weiter versucht. Jetzt fragt Home Assistant nach dem neuen Passwort und sagt dazu, wenn das Konto gesperrt ist. Im selben Release hat Garm82 dafür gesorgt, dass das schnelle Abfrageintervall nicht mehr hängen bleibt. Im schlimmsten Fall hat die Integration bis zum nächsten Neustart alle fünf Sekunden nachgefragt. Das Prinzip aus dem Februar 2024 eben.

Wie das neben dem Job klappt

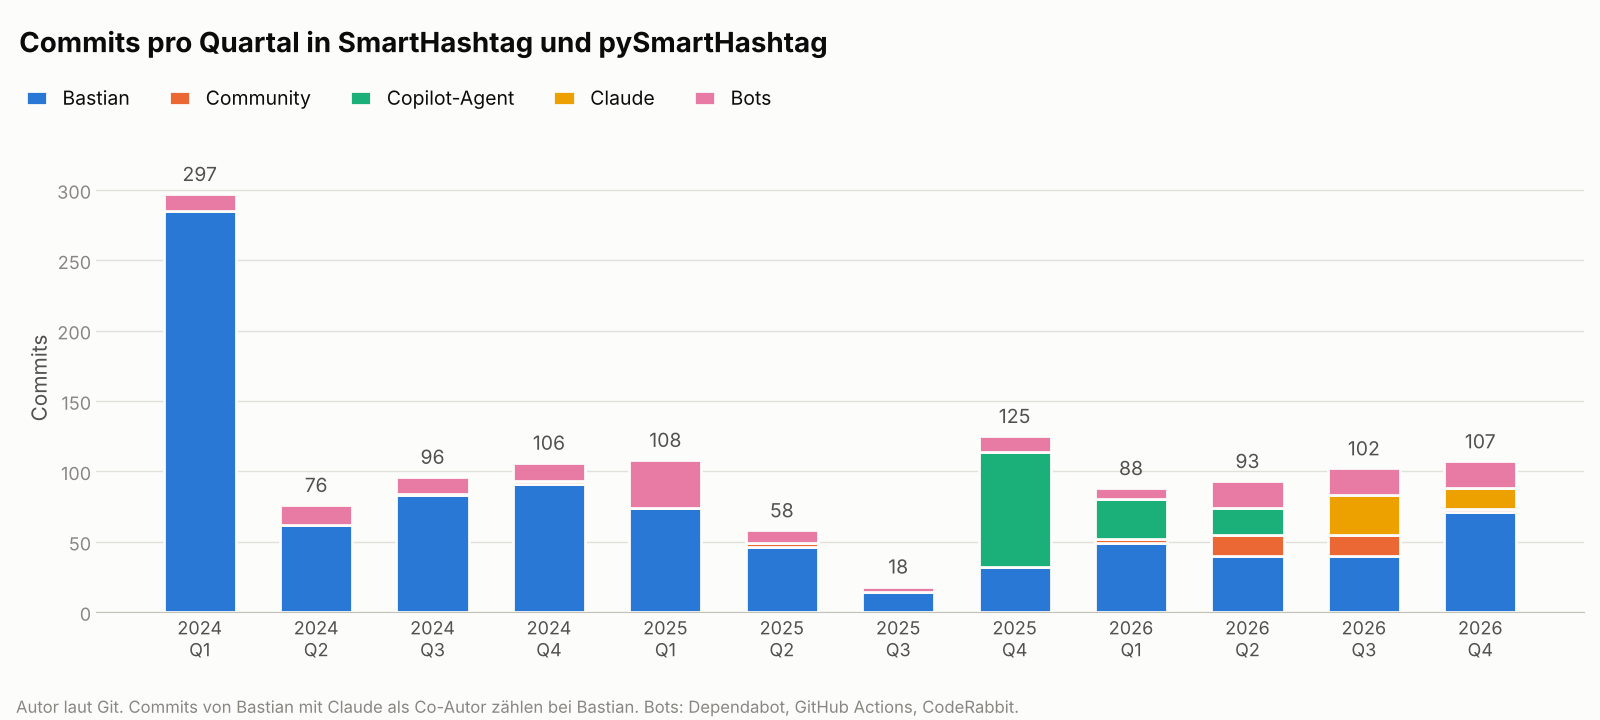
Gestapeltes Balkendiagramm der Commits pro Quartal von 2024 bis 2026, aufgeteilt nach Bastian, Community, Copilot-Agent, Claude und Bots
Commits pro Quartal in beiden Repositories, aufgeteilt nach Autor. Nach dem Start im Februar 2024 und der Pause im Sommer 2025 übernehmen ab Ende 2025 die Agenten einen sichtbaren Teil.

Ehrlich gesagt: Ohne KI-Agenten wäre SmartHashtag nicht da, wo es heute ist. In der Integration stehen 86 Commits vom Copilot-Agent und 28 von Claude, dazu 18 von mir mit Claude als Co-Autor. Ich arbeite hier genauso wie bei India Navi: Ich beschreibe das Problem und das Ziel dahinter, der Agent liefert einen Pull Request, und am Ende entscheidet der Test am Auto. Die Heckklappe zeigt, warum ich auf diesen letzten Schritt nicht verzichte. Wie ich mit den Agenten rede, darum ging es im Mai in Wie redet ihr eigentlich mit euren KI-Agenten?

Aus 546 Zeilen Python im Februar 2024 sind gut 4900 Zeilen Integration geworden, dazu noch einmal so viele Zeilen Tests. Aus einem einzigen Sensor-Modul wurden neun Plattformen, von Sensoren über Schlösser bis zu Knöpfen für Hupe und Licht. Das Repository hat 72 Sterne und 9 Forks.

Wer einen Smart #1, #3 oder #5 fährt: Die Integration gibt es über HACS, Fehlerberichte und Pull Requests sind willkommen. Gerade beim #5 hilft jeder Mitschnitt aus der App.

Wie eine Karte mit 3 GB auf einen ESP32 passt

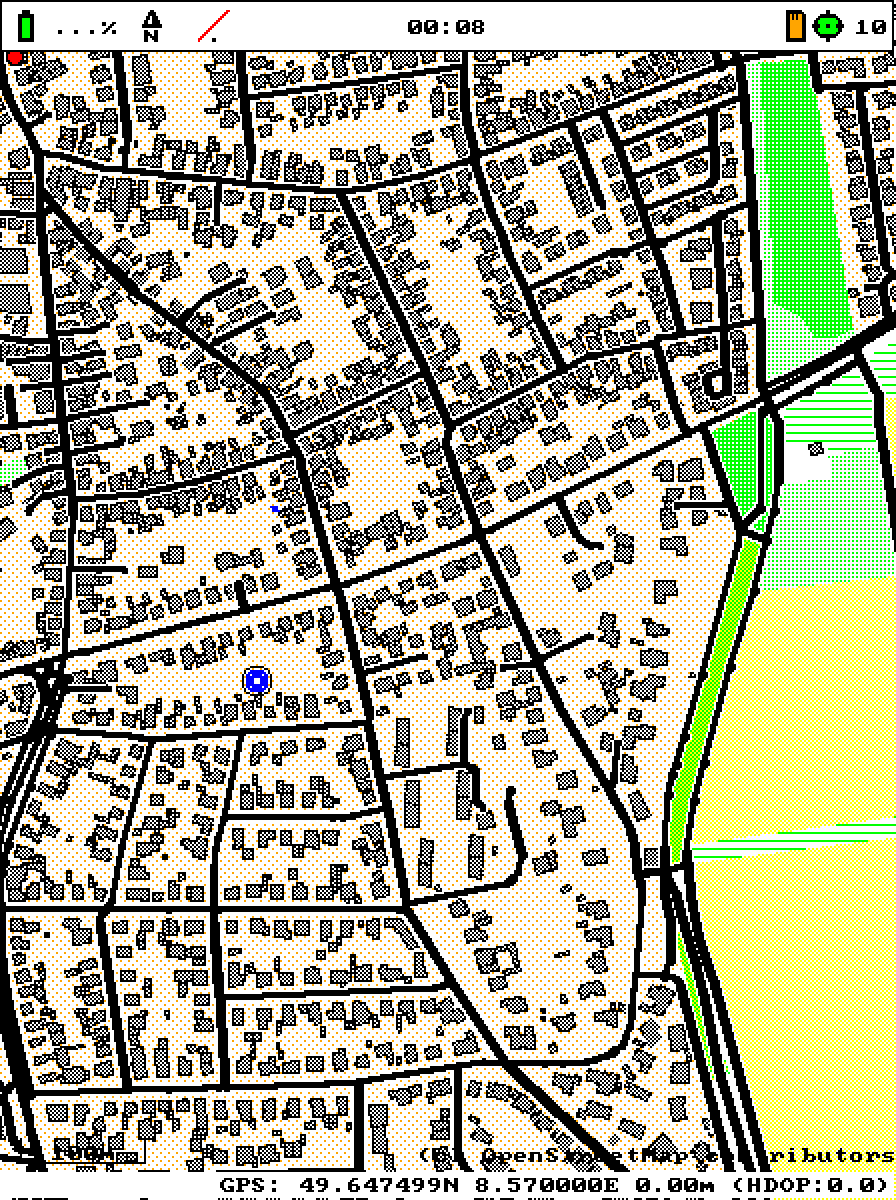
Vektorkarte von Lorsch auf Zoomstufe 16 in den sieben Farben des E-Paper-Displays
Lorsch auf Zoomstufe 16, direkt aus einer Mapsforge-Datei gerendert. Straßen, Gebäude als gerastertes Muster, Felder und Wiesen in den sieben Farben des Displays. Kartendaten © OpenStreetMap-Mitwirkende.

Kartenkacheln haben einen Haken: Man muss vorher wissen, wo man hin will. Für jede Tour Kacheln laden, umrechnen und übertragen, das funktioniert, ist aber genau die Art Vorbereitung, die man vor einer spontanen Wanderung nicht machen will. Die Lösung gibt es schon lange: Mapsforge, das Vektorkartenformat, das viele Offline-Kartenapps auf dem Handy nutzen. Eine Datei für eine ganze Region auf der SD-Karte, und das Gerät zeichnet die Karte selbst.

mapsforge-rs

Im ersten Beitrag hatte ich erwähnt, dass der Versuch, die ganze Firmware nach Rust zu portieren, nicht in main gelandet ist. Rust kam trotzdem, als eigene Bibliothek: mapsforge-rs liest Mapsforge-Dateien und liefert Polygone, Linien und Punkte. Ein kleiner Rasterizer in C zeichnet sie direkt in den Framebuffer. Die Firmware ruft das über eine C-Schnittstelle auf und verankert die Vektorkarte am selben Pixel wie die Kachelkarte. Marker, Track und Wegpunkte funktionieren deshalb ohne Änderung weiter. Liegt keine MAPS/map.map auf der Karte, nimmt India Navi wie bisher die Kacheln.

Für den ESP32-S3 heißt das: Rust für Xtensa. Die Toolchain kommt über espup, gebaut wird mit -Zbuild-std für core und alloc. Ein Build-Skript für PlatformIO baut die Bibliothek mit cargo und linkt sie dazu. Seit dem 25. Oktober ist mapsforge-rs ein Submodul, ein rekursiver Clone baut also direkt mit Vektorkarte, und die CI installiert die Toolchain selbst.

70 Millisekunden pro Seek

Die erste Version hat auf dem Gerät 9 Sekunden für ein Bild gebraucht. Der Grund war nicht die Grafik, sondern das Dateisystem. Eine Mapsforge-Datei ist nicht linear zu lesen, sie springt ständig zu den Daten der benötigten Kachel. In einer Datei mit 3 GB hat FatFs bei jedem Sprung die Cluster-Kette von vorne abgelaufen, 70 ms pro Seek. Mit Fast Seek von FatFs wird daraus ein Tabellenzugriff. Die Cluster-Tabelle aufzubauen dauert einmalig 5 Sekunden und bleibt erhalten, solange die Datei gleich bleibt. Danach dauert ein Bild etwa 1 Sekunde. Der Heap der Bibliothek liegt im PSRAM, gelesen wird über einen kleinen DMA-Puffer im internen RAM. Die Lektion aus dem Speicher-Audit wirkt also nach.

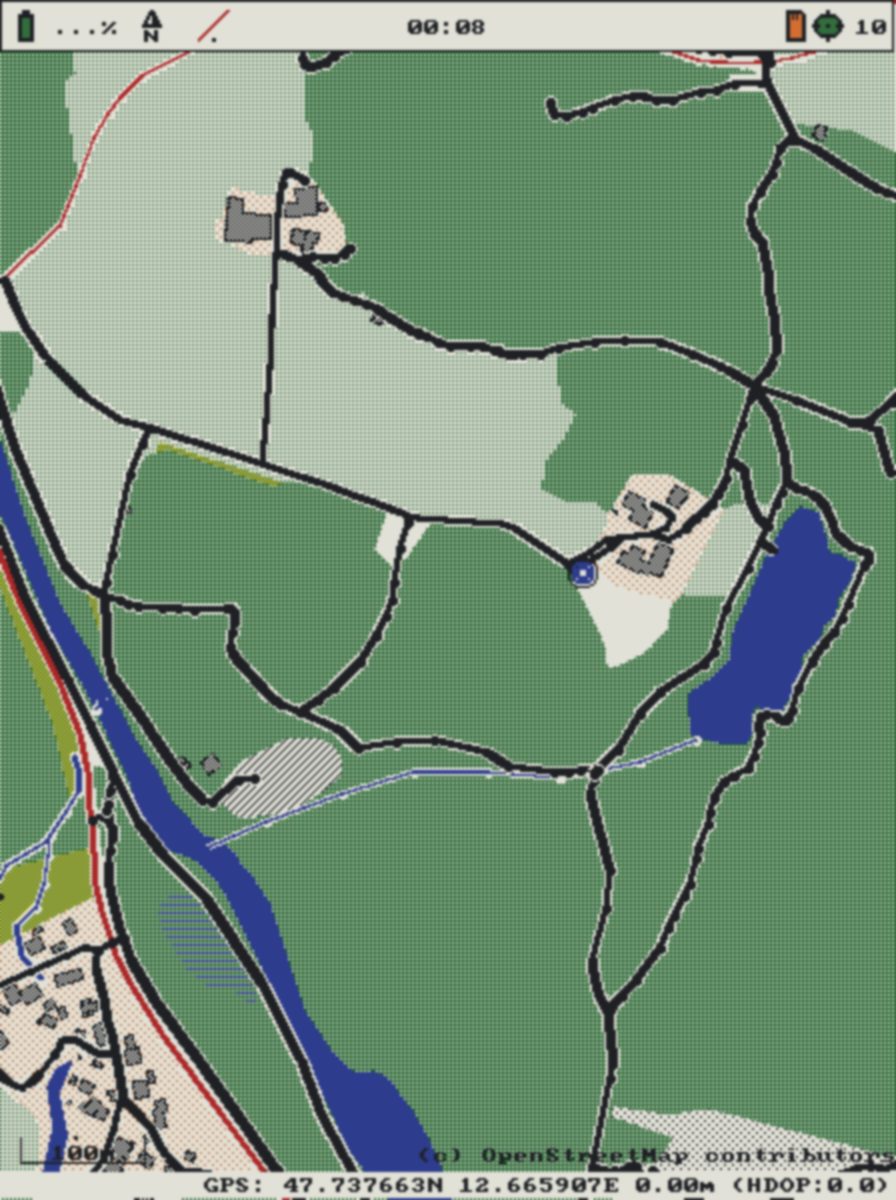
Vektorkarte von Traunstein auf Zoomstufe 16 als Annäherung an das E-Paper-Panel mit Wald, Wiese, See und Fluss
Traunstein auf Zoomstufe 16 als Annäherung an das echte Panel, mit gedämpften Farben und leichter Unschärfe. Wald, Wiese, See, Fluss und Feuchtgebiet bekommen jeweils eine eigene Mischung der sieben Farben.

Farben, Muster und Namen

Viel Arbeit steckt nicht im Code, sondern in der Frage, wie eine Karte mit sieben Farben gut aussieht. Gemischte Flächen wie Gebäude oder Wiesen werden mit einem Muster aus Vorder- und Hintergrundfarbe gefüllt. Damit das schnell geht, habe ich den Linux-Simulator der Firmware erweitert: Er rendert die Vektorkarte auf dem PC und speichert auf Wunsch einen Screenshot. Ein Skript baut, rendert und speichert ein PNG, so lässt sich ein Kartenstil in Sekunden prüfen statt in Minuten mit Flashen. Inzwischen stehen auch Ortsnamen in der 8 × 8 Schrift auf der Karte.

In der App erklärt seit Version 1.4.0 der Filterbildschirm im Modus „Vektor“, wie Flächen, Wege und POIs auf dem Gerät aussehen. Wer unterwegs auf ein Muster schaut, kann dort nachsehen, was es bedeutet.

Und bis der GPS-Fix da ist?

Kartenbildschirm von India Navi ohne GPS-Fix: Wanderer, Logo, Satellit und der Text Searching for GPS
So sieht die Karte aus, bis die Position bekannt ist. Screenshot aus dem Linux-Simulator.

Ohne Fix blieb der Kartenbildschirm bisher einfach weiß. Jetzt zeigt er den Wanderer aus dem Splash Screen, dazu einen Satelliten, der ihm Signale schickt, und „Searching for GPS…“. Das Bild erzeugt ein Skript aus der Vorlage: Jeder Pixel bekommt eine Klasse, jede Klasse eine der sieben Farben oder ein 4 × 4 Bayer-Muster, der Farbverlauf im Schriftzug wird zu roten, orangen und gelben Bändern. Lauflängenkodiert braucht das Bild etwa 12 KB im Flash und wird beim Zeichnen dekodiert, ohne RAM-Puffer. Sobald der erste Fix kommt, löst die GPS-Task einen Refresh aus und die Karte ersetzt das Bild.

Was als Nächstes kommt? Light Sleep, sobald die Peripherie dafür bereit ist, und echte Touren mit der Vektorkarte. Das Navi ist jetzt nach Jahren zum ersten Mal an dem Punkt, an dem ich es einfach mitnehmen will. Wer mitbauen will: Firmware und App liegen auf GitHub.

Wie das Wandernavi schneller zeichnet und länger durchhält

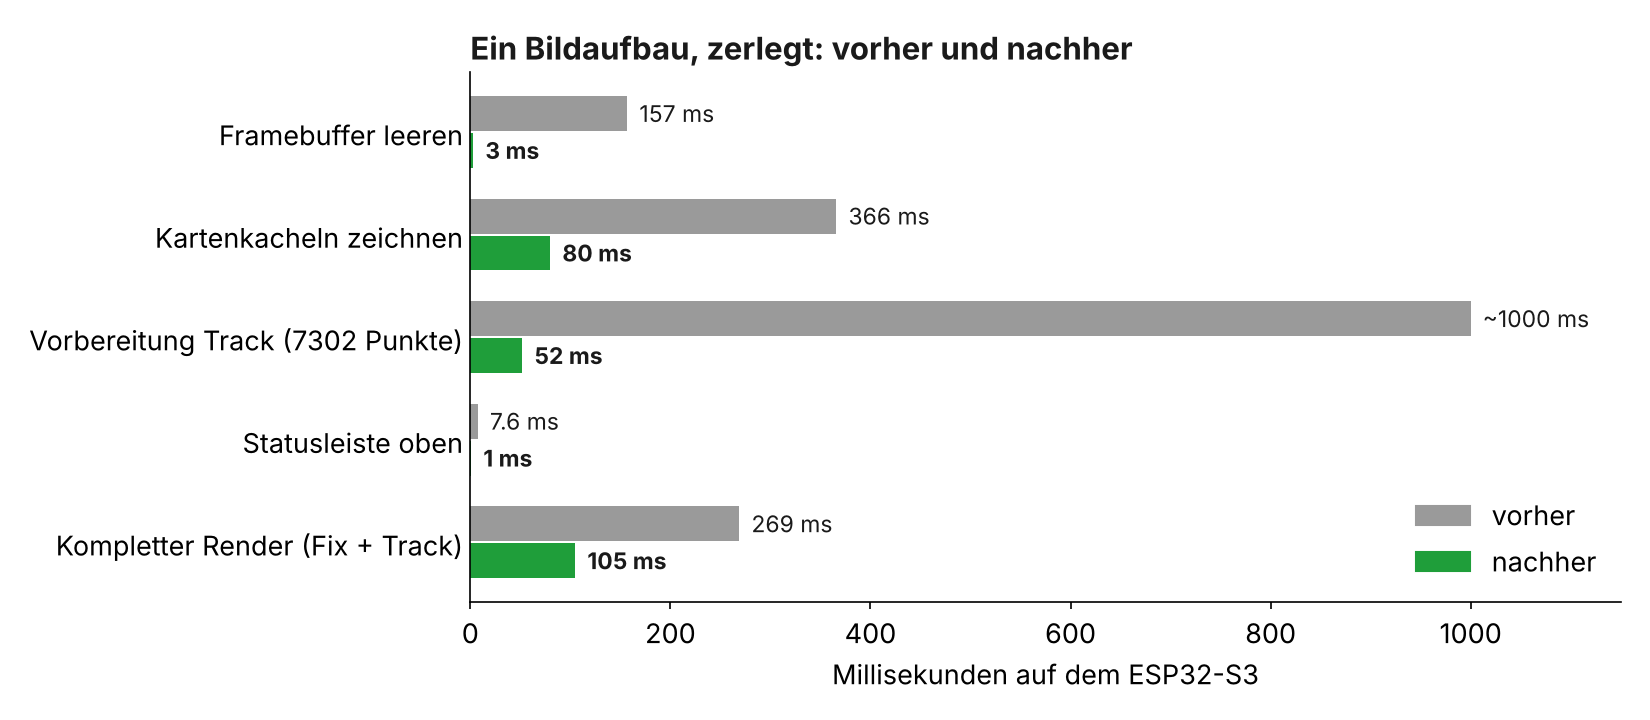
Balkendiagramm der Renderzeiten vorher und nachher, kompletter Render von 269 auf 105 Millisekunden
Gemessen auf dem ESP32-S3 mit einem Track aus 7302 Punkten. Die Zahlen stammen aus den Commits vom 10. Oktober.

Bei einem E-Paper, das 17 Sekunden für einen Refresh braucht, ist Rendergeschwindigkeit doch egal? Nicht ganz. Jede Millisekunde, in der die CPU auf 240 MHz rechnet, kostet Akku. Und ein Wandernavi, das nach einem halben Tag leer ist, ist ein Briefbeschwerer. Also habe ich am 10. Oktober einen Bildaufbau auseinandergenommen und nachgeschaut, wo die Zeit bleibt.

Wo die Zeit bleibt

Der größte Brocken war die Mathematik. Jeder Bildaufbau hat für jeden Wegpunkt des Tracks die Kachel berechnet, mit pow, log, tan und cos in doppelter Genauigkeit. Das macht der ESP32-S3 in Software, und bei einem langen Track hat das rund eine Sekunde pro Render gekostet. Jetzt wird die Position eines Wegpunkts einmal beim Laden als 32-Bit-Festkommawert auf der Weltkarte gespeichert. Kachel und Pixel einer Zoomstufe sind dann nur noch Bitshifts. Die Position des Geräts nutzt dieselbe Rechnung, damit Marker und Track auf denselben Pixeln landen.

Der zweite Brocken war das Zeichnen Pixel für Pixel. Den Framebuffer zu leeren hat jeden der 268 800 Pixel einzeln gesetzt und 157 ms gedauert, mit memset sind es 3 ms. Kartenkacheln werden jetzt auf das Display zugeschnitten, bevor sie gezeichnet werden, und zeilenweise kopiert, zwei Pixel pro Byte. Pixel für Pixel lag jeder Schreibzugriff in einer anderen Cache-Line des PSRAM. Das Ergebnis ist Byte für Byte identisch, das habe ich auf dem Gerät geprüft.

Dazu kleinere Dinge. Der Track wird pro Render nur noch einmal durchlaufen statt fünfmal, jeder Durchlauf durch die Liste im PSRAM kostete 6 ms, auch wenn er nichts tat. Das Höhenprofil mit 7302 Punkten wird einmal in einen Canvas gezeichnet und danach nur noch kopiert. Ein kompletter Render mit GPS-Fix und Track ging so von 269 ms auf 172 ms. Den Rest bis 105 ms holt der Release-Build mit -O2 und ohne Heap-Poisoning. Einen Track laden dauert jetzt 1,1 statt 1,8 Sekunden.

Weniger Takt, weniger Funk

Mit aktivem Power Management läuft die CPU nur noch mit 240 MHz, wenn eine Task sie braucht, sonst mit 80 MHz. Tiefer geht es nicht, weil Bluetooth und der UART des GPS am APB-Takt von 80 MHz hängen. Auf dem Kartenbildschirm mit Fix läuft die CPU 10 % der Zeit auf vollem Takt. Light Sleep bleibt vorerst aus, dafür sind UART, Bluetooth und die Versorgungspins noch nicht bereit.

Bluetooth war der nächste Verbraucher. Ein Handy, das 5 Minuten weder liest noch schreibt, wird jetzt getrennt. Danach sendet India Navi nur noch für 5 Sekunden Advertising, und zwar immer dann, wenn das Display ohnehin neu zeichnet. Dazwischen ist der Bluetooth-Stack komplett gestoppt. Die App weiß das und wartet beim Wiederverbinden auf das nächste Display-Update.

Auch wenn der Akku leer ist, passiert jetzt etwas Sinnvolles. Nach drei Messungen in Folge bei 5 % ohne Ladegerät zeigt das Display „Battery empty“, das GPS-Modul geht in Standby, damit es seine Uhr behält, und das Gerät in Deep Sleep. Das Bild bleibt auf dem E-Paper stehen, ohne Strom zu brauchen. Kommt ein Ladegerät dazu, startet die Karte von selbst, sobald der Akku sich erholt hat.

Aufräumen, bevor es zu spät ist

Am gleichen Wochenende habe ich die Task-Architektur umgebaut. Vorher deklarierte eine tasks.h die Schnittstelle jedes Moduls, main.c enthielt die Power-Task und den Button, und Event-Queue, SD-Mutex und Akkuwerte waren globale Variablen, die jeder direkt benutzte. Jetzt hat jedes Modul einen eigenen Header in include/navi/ und startet seine Task selbst. Die Event-Queue und der SD-Mutex sind privat, die GUI fragt den Status der Module ab, statt dass die Tasks GUI-Objekte beschreiben. Von außen sieht man davon nichts, aber der Umbau hat einen Fehler ans Licht gebracht: Ein Tastendruck, während das Ausschaltbild noch gezeichnet wurde, hat das Gerät direkt wieder eingeschaltet.

Apropos Taste: Ein kurzer Druck auf der Karte hat das Gerät manchmal ausgeschaltet statt den Zoom zu wechseln. Jedes Prellen belegte einen Platz in der Event-Queue der Größe 6, das Loslassen ging verloren und der Timer für den langen Druck lief ab. Jetzt meldet der Interrupt nur noch eine Änderung, und die Haupttask liest den Pegel nach 30 ms. Manchmal ist Embedded eben doch noch Elektronik.

Warum ein Pairing-Code 17 Sekunden zu spät kam

WLAN ist toll, um ein paar hundert Kartenkacheln auf die SD-Karte zu schieben. Für alles andere ist es zu umständlich. Niemand will unterwegs einen QR-Code scannen, nur um die Trackfarbe zu ändern. Seit dem 6. Oktober ist India Navi deshalb ein Bluetooth-LE-Peripheral, solange es eingeschaltet ist. Die Firmware nutzt NimBLE auf dem ESP32-S3, die App react-native-ble-plx.

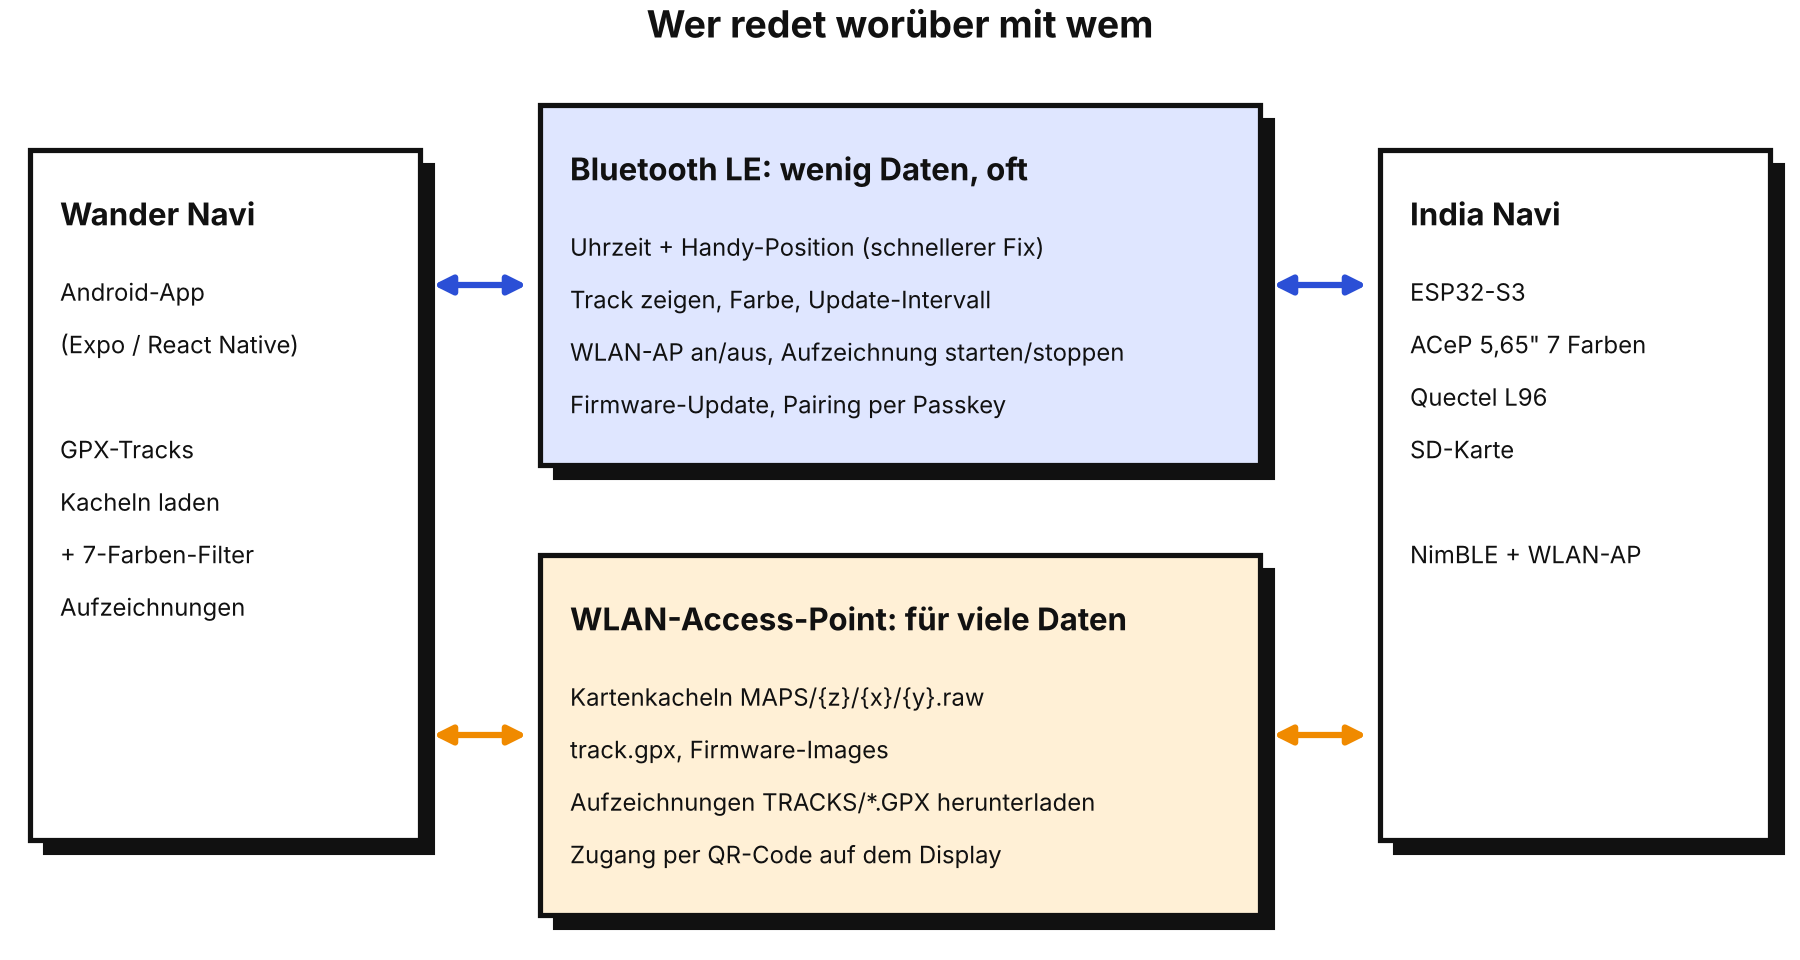
Diagramm: Wander Navi und India Navi sprechen über Bluetooth LE für Einstellungen, Zeit, Position und Updates, über den WLAN-Access-Point für Kacheln, Tracks und Firmware
Zwei Kanäle, zwei Aufgaben: Bluetooth für die kleinen Dinge, die oft passieren, WLAN für die großen Datenmengen.

Über Bluetooth schickt die App die Uhrzeit und die Position des Handys. Beides geht weiter an das GPS-Modul (PMTK740/PMTK741), damit es die Satelliten schneller findet. Bis zum ersten eigenen Fix zeigt die Karte die Handyposition, ins Log kommt sie nie. Außerdem lässt sich der Access Point ein- und ausschalten, der Track und das Höhenprofil ein- und ausblenden und das Update-Intervall des Displays zwischen 30 Sekunden und 10 Minuten wählen. Das WLAN-Passwort geht nie über Bluetooth, das liest das Handy weiterhin vom Display.

Wenn die Theorie auf das E-Paper trifft

Die erste Version war in Teilen von einem Agenten geschrieben, ohne ESP-IDF-Toolchain. Im Commit steht das auch offen drin: Host-Tests grün, der ESP-Code nur gegen Stub-Header geprüft. Auf der Hardware ging dann erst einmal gar nichts. Drei Fehler, alle lehrreich:

  1. Bluetooth startete nicht, weil der Controller nur noch 2 KB internes RAM fand. Der Framebuffer mit 134 KB liegt jetzt im PSRAM und wird Byte für Byte ohne DMA verschickt.
  2. Der Pairing-Code erschien zu spät. Das Handy hat 30 Sekunden zum Pairen, ein Refresh des 7-Farben-Displays dauert rund 17 Sekunden. Jetzt wird der Code gewählt, sobald ein Handy verbindet, und für den nächsten Versuch behalten.
  3. Ein gepaartes Handy kam nicht wieder rein. Ein Kommando im Connect-Event hat den Host blockiert, während der Controller auf die Antwort zur Schlüsselanfrage wartete.

Ein vierter Fehler kam etwas später. Android schickt nach dem Wiederverbinden eine Indication, und NimBLE ohne GATT-Client antwortet mit „Request Not Supported“. Android hielt das für die Antwort auf die MTU-Anfrage der App, und die App gab 0,2 Sekunden nach dem Verbinden auf. Die Central-Rolle bringt den GATT-Client mit. Das Image wird dadurch 16 KB größer, der freie Heap bleibt gleich.

Firmware-Update aus der Hosentasche

Das Firmware-Update funktioniert jetzt über WLAN und über Bluetooth. Ein getaggter Release auf GitHub hängt die Firmware automatisch an. Die App bietet die neueste Version aus den GitHub Releases direkt zum Update an. Damit ein kaputtes Image das Gerät nicht unbrauchbar macht, ist Rollback aktiv: Eine neue Firmware gilt erst als bestätigt, wenn sie 60 Sekunden gelaufen ist. Stürzt sie vorher ab, startet der Bootloader die alte Version.

Tracks aufzeichnen

Das alte log.gpx, das einfach alles mitgeschrieben hat, ist Geschichte. Aufzeichnungen startet und stoppt man jetzt in der App. Jede Aufzeichnung landet als eigene Datei in TRACKS/ auf der SD-Karte, benannt nach der Startzeit, mit einem neuen Segment nach jedem Neustart. Die App listet und löscht die Aufzeichnungen über Bluetooth und lädt sie über WLAN herunter.

Statusleiste von India Navi mit Akku, Nordpfeil, Access-Point- und Bluetooth-Symbol
Die Statusleiste zeigt Akku, Nordpfeil, Access Point und die Bluetooth-Rune. Mit zwei Punkten daneben ist ein Handy verbunden.

Zwei Erkenntnisse nehme ich mit. Erstens: Ein Agent kann ein Protokoll sauber entwerfen und testen, die Fehler am echten Gerät findet er ohne Gerät nicht. Die Arbeitsteilung war deshalb klar: Er schreibt den Code, ich probiere ihn am Gerät aus. Zweitens: Bei einem Display, das 17 Sekunden für ein Bild braucht, muss man bei jedem Timeout im Protokoll diese 17 Sekunden einplanen.

Endlich eine App für das Wandernavi

App-Icon von Wander Navi mit Nordpfeil auf grünem Grund und der Splash Screen mit Schriftzug
Links das App-Icon, rechts der Splash Screen. Der Nordpfeil kommt direkt aus den Icons der Firmware.

Das größte Problem von India Navi war nie die Firmware. Es war der Weg der Karte auf die SD-Karte. Bisher hieß das: GPX-Datei nehmen, mit dem Converter die Kacheln für Zoomstufe 14 und 16 herunterladen, jede Kachel in das 4-Bit-Format des Displays umrechnen, alles in die richtige Ordnerstruktur kopieren, SD-Karte raus, SD-Karte rein. Das macht man genau einmal mit Begeisterung.

Das Repository IndiaNavi_App gibt es seit Oktober 2022. Es enthielt genau einen Commit: das, was create-expo-app erzeugt. Vier Jahre später wurde daraus eine echte App. Zuerst das Update von Expo SDK 46 auf 57, also React Native 0.86 und React 19. Der alte GPX-Parser brauchte Node-Bibliotheken, die sich in React Native nicht bündeln lassen, also flog er raus. Und die App bekam einen neuen Namen: Wander Navi.

Vom Track zur SD-Karte

Die App öffnet eine GPX-Datei über den Dateidialog oder über „Öffnen mit“ auf Android. Sie berechnet den Bereich um den Track, lädt die Kacheln und rechnet sie in die sieben Farben des Displays um. Die Farbumrechnung ist aus dem alten Rust-Converter portiert. Mit dem Standardfilter ist die Ausgabe Byte für Byte identisch mit der Rust-Version. Dabei ist auch ein alter Fehler aufgefallen: Der Converter hat den Rand um den Track nicht auf allen Seiten berücksichtigt.

Inzwischen geht es auch ohne Track. Die Startansicht ist eine Karte, die man verschieben und zoomen kann, mit Suche nach Orten und Koordinaten. Der Bereich um das Kreuz in der Mitte wird geladen. Als Kartenquelle ist Thunderforest Outdoors voreingestellt, der API-Key hängt die App unsichtbar an jede Anfrage.

Sieben Farben sind nicht viel

Ein E-Paper mit Schwarz, Weiß, Grün, Blau, Rot, Gelb und Orange zeigt keine Pastelltöne. Im Filterbildschirm der App lassen sich deshalb zwei Displayfarben in beliebigem Anteil mischen, in Schritten von 1/16. Gemischt wird mit einem 8 × 8 Bayer-Muster, das über die Kachelgrenzen hinweg weiterläuft. Linien und Schrift würden im Muster zerfallen. Pixel, die deutlich dunkler sind als ihr hellster Nachbar, werden deshalb in der dunkleren Farbe durchgezogen. Original und Umrechnung kann man nebeneinander vergleichen, per Pinch bis auf den einzelnen Pixel. Den Filter kann man als JSON exportieren und wieder importieren.

Übertragung per WLAN

Damit das Kopieren der SD-Karte entfällt, hat die Firmware einen WLAN-Access-Point bekommen. Hängt India Navi am Ladegerät, öffnet es ein Netz IndiaNavi-XXXX mit WPA2 und zeigt Name und Passwort als QR-Code auf dem Display. Die App scannt den Code, verbindet sich und lädt die Dateien über eine kleine HTTP-API hoch. Weil das Netz kein Internet hat, braucht es dafür ein eigenes Expo-Modul, das die App an genau dieses WLAN bindet.

Display von India Navi mit Fortschrittsanzeige Upload 8 von 12 Dateien
Die App kündigt die Anzahl der Dateien an, das Display zeigt den Fortschritt. Screenshot aus dem Linux-Simulator der Firmware.

Kacheln, die schon auf der Karte liegen, werden übersprungen. Hochgeladen wird über zwei Verbindungen mit Wiederholung, track.gpx kommt als letzte Datei. Die Firmware schreibt jede Datei erst in eine .tmp und benennt sie um, wenn alle Bytes angekommen sind. Ohne Ladegerät schaltet sich das WLAN nach 10 Minuten ohne Nutzung ab.

Eine App, die aussieht wie das Gerät

Am 5. Oktober bekam die App ein Redesign nach dem Vorbild des Displays: nur die sieben Farben des E-Papers, flache Flächen mit schwarzen Rändern und harten Schatten. Die Icons erzeugt ein Skript direkt aus den Quellen der Firmware. Seitdem sieht die App aus wie ein Stück India Navi auf dem Handy. Mit einem GitHub Workflow, der bei jedem Push ein APK baut, ging es dann in kurzen Schritten bis zur Version 1.4.0 am 25. Oktober.

India Navi lag zwei Jahre in der Schublade

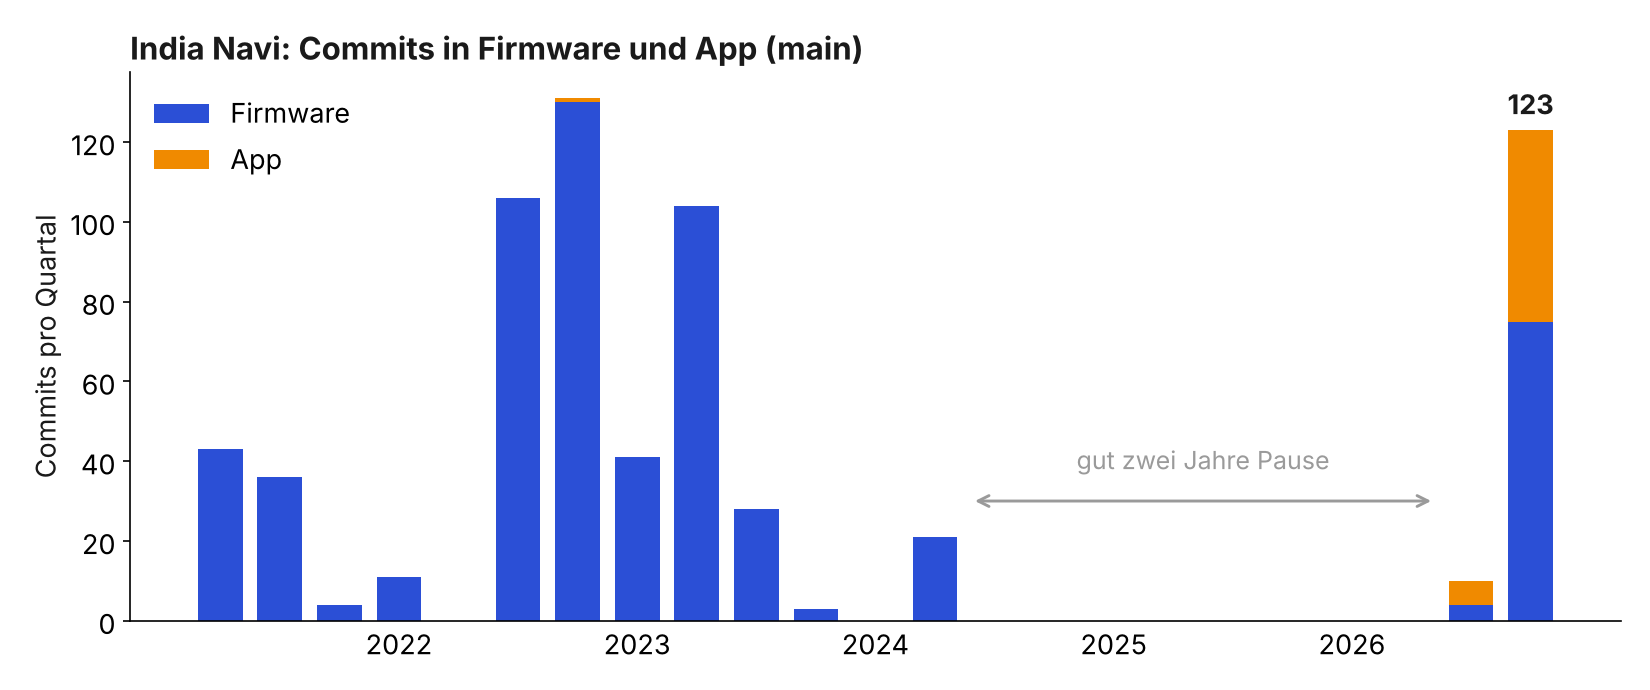
Der letzte Commit im India Navi Repository vor der langen Pause trägt das Datum 31. Mai 2024. Power Management für Light Sleep, eine neue Batterieanzeige, GPS-Punkte auf die SD-Karte loggen. Danach war Schluss. Das Studium, die Gruppenleitung, das Leben. Das Gerät lag in der Schublade, die Firmware auf GitHub und beide haben geduldig gewartet.

Balkendiagramm der Commits pro Quartal in Firmware und App von 2021 bis 2026, mit gut zwei Jahren Pause
Commits pro Quartal auf main in IndiaNavi_Firmware und IndiaNavi_App. Nach Mai 2024 war gut zwei Jahre Ruhe, im Oktober 2026 kamen 123 Commits zusammen.

Für alle, die India Navi nicht mehr auf dem Schirm haben: India Navi ist ein Offline-Navi zum Wandern. Kein Turn-by-Turn, kein „in 200 Metern links abbiegen“. Es zeigt die eigene Position auf einer Karte von der SD-Karte, dazu einen GPX-Track mit Höhenprofil, und aktualisiert das Bild jede Minute. Herzstück ist ein ESP32-S3 mit 16 MB Flash und 8 MB PSRAM, dazu das 7-Farben E-Paper von Waveshare mit 5,65 Zoll und 600 × 448 Pixeln und ein Quectel L96 als GNSS-Modul. Nicht verirren statt navigieren, das war von Anfang an das Ziel. Wer die Vorgeschichte nachlesen will: das Update vom Juni 2021 und die Firmware 2.0r2.

Der Splash Screen von India Navi: Schriftzug und ein Wanderer mit Rucksack und Stock
Der Wanderer mit Rucksack und Stock ist seit Jahren das Gesicht des Projekts. Die Vorlage liegt jetzt auch in der Dokumentation des Repositories.

Erst einmal wieder bauen können

Wer ein Embedded-Projekt zwei Jahre liegen lässt, kennt das: Nichts baut mehr. Die PlatformIO-Plattform hatte sich weiterbewegt, ESP-IDF auch. Der erste Schritt Ende September war deshalb das Update auf ESP-IDF 6.1 (espressif32 7.1.3) samt GCC 15. Klingt nach Versionsnummer hochdrehen, war es aber nicht. FatFs alloziert seine Puffer jetzt nur noch, wenn der Zeiger im FIL-Objekt NULL ist. Ohne Nullinitialisierung ist das Gerät beim Booten abgestürzt. Dazu ein Pufferüberlauf in ctime_r(), das 26 Byte braucht, und eine Handvoll geänderter API-Aufrufe für SD-Karte, Wakeup-Ursachen und HTTP-Client.

Ein Speicher-Audit, das wehgetan hat

Direkt danach habe ich den Code einmal komplett auf Speicherfehler durchsucht. Die Liste ist lang und liegt als MemoryAudit.md im Repository. Ein paar Highlights: Der NMEA-Parser hat seine Plugins als Zeiger auf den Stack des Aufrufers gespeichert. Ein PMTK001-Ack hat einen Funktionszeiger außerhalb des Arrays aufgerufen. Fehlte eine Kartenkachel, blieb der SD-Mutex gesperrt und das Gerät stand still. Der GPX-Parser hat unvollständige Dateien für immer neu geparst. Und das Höhenprofil hatte einen Heap-Überlauf. Dazu Lecks im OTA-Puffer alle 30 Sekunden und bei jedem Aus- und Einschalten.

Der spannendste Fund war aber kein Bug im klassischen Sinn. Ein GPX-Track mit 154 KB hat den kompletten internen RAM gefressen, 59 Byte waren noch übrig. Jeder Trackpunkt ist eine kleine Allokation, und kleine Allokationen landen im internen RAM. Dann konnte der SD-Kartentreiber seine DMA-Puffer nicht mehr anlegen und die Karte blieb weiß. Seitdem liegen Trackpunkte, Höhenprofil und Dateipuffer im PSRAM. Mit dem gleichen Track bleiben jetzt 30 KB internes RAM frei.

Altlasten abarbeiten

Am 6. Oktober habe ich mir dann die offenen Issues vorgenommen. Manche davon lagen schon peinlich lange herum. Das log.gpx wurde bei jedem Boot geleert und nie beschrieben, weil die GPS-Task auf ein Flag gewartet hat, das niemand gesetzt hat. Die Uhrzeit aus dem GPS war nur in Zeitzonen mit UTC+1 richtig, weil irgendwann jemand (ich) eine Stunde draufaddiert hat. Das Höhenprofil eines Tracks unter Meeresniveau wurde nie gezeichnet, weil der Wertebereich vorzeichenlos war. Und der nächste Wegpunkt war nur dann der nächste, wenn er auf beiden Achsen näher lag. Sechzehn Issues an einem Tag geschlossen, dazu ein Release v3.0.0. Die letzte Version davor war v2.1.1 aus dem Juni 2023.

Wie das in der Zeit möglich war

Ehrlich gesagt: Dieses Tempo hätte ich neben dem Job alleine nicht geschafft. Wer in die Commit-Historie schaut, sieht an vielen Stellen „Claude“ als Autor oder eine Claude-Session im Commit-Text. In meinem letzten Beitrag habe ich gefragt, wie ihr mit euren KI-Agenten redet. India Navi ist mein Versuchsfeld dafür geworden. Das Muster, das sich bewährt hat: Ich beschreibe das Problem mit Kontext und dem Ziel dahinter, der Agent liefert einen Pull Request, ich teste auf echter Hardware und schreibe dann die Fixes, die nur am Gerät auffallen. Nicht alles hat funktioniert. Ein Agent hat parallel angefangen, die ganze Firmware nach Rust zu portieren. Das liegt in eigenen Branches und ist nicht in main gelandet. Rust ist trotzdem ins Projekt gekommen, aber anders, dazu später mehr.

In den nächsten Beiträgen geht es um die App, um Bluetooth, um schnelleres Rendern und um Vektorkarten. In einem Monat ist ganz schön viel passiert.

Wie redet ihr eigentlich mit euren KI-Agenten?

Die meisten von uns arbeiten täglich mit KI-Agenten: beim Code-Review, beim Verfassen von Dokumentation, beim Debuggen, beim Aufsetzen von Testszenarien. Aber kaum jemand fragt sich, wie er eigentlich effektiv mit diesen Agenten spricht und ob die eigene Art zu kommunizieren wirklich die beste ist.

Wenn ich mir anschaue, wie unterschiedlich das aussieht, bin ich jedes Mal fasziniert. Manche tippen kurze, technische Befehle, präzise, direkt, fast wie ein CLI-Kommando. Andere formulieren ihre Anfragen wie eine Nachricht an einen Kollegen: mit Kontext, mit dem Ziel dahinter, manchmal sogar mit einer kleinen Erklärung, warum sie etwas brauchen. Manchmal auch mit den üblichen Nettigkeiten wie bitte und danke. Beide Ansätze liefern Ergebnisse. Aber liefern sie die besten Ergebnisse für die jeweilige Aufgabe?

Wir optimieren unseren Code, unsere Prozesse, unsere Deployments. Aber die Art, wie wir mit unseren KI-Werkzeugen kommunizieren, lassen wir meist auf dem Stand, auf dem wir sie zufällig kennengelernt haben.

Ich gehe in den nächsten Wochen bewusst auf Entdeckungsreise. Probiere bei der nächsten größeren Aufgabe mal beide Stile aus. Einmal kurz und direkt, einmal mit vollem Kontext und Zielbeschreibung. Mal schauen, was rauskommt. Nicht nur die Qualität der Antwort, sondern auch, wie viele Iterationen ich brauche, bis das Ergebnis wirklich passt. Notiert eure Beobachtungen, egal wie klein.

Ich glaube nicht, dass es die eine richtige Art gibt, mit einem KI-Agenten zu sprechen, es hängt von der Aufgabe ab, vom Kontext, vielleicht sogar vom eigenen Arbeitsstil. Aber ich glaube fest daran, dass wir deutlich mehr aus diesen Werkzeugen herausholen können, wenn wir unsere Erfahrungen teilen. Was bei Code-Reviews funktioniert, könnte sich grundlegend davon unterscheiden, was beim Schreiben von User Stories hilft.

Also: Wie redet ihr mit euren KI-Agenten? Ich bin gespannt auf eure Erfahrungen.

Ein neues Team gründen ist gar nicht so leicht

Nach einigen Jahren, die wir mit der Entwicklung eines neuen Produkts verbracht hatten, bei dem eine Verzögerung die nächste eingeholt hat wurde die Entwicklungsabteilung einer „agilen Transformation“ unterzogen. Es wurden aus Sparten eine gemeinsame Entwicklungsabteilung aufgebaut. Mit Gruppen (Chaptern) die die Gewerke Mechanik, Elektronik und Software abdecken und von jeweils einem Gruppenleiter (Senior Chapter Lead) geführt wurden. Innerhalb der Gruppe gab es Teamleiter (Chapter Lead) für spezielle Themenbereiche die wiederum zwischen 4 und 10 Mitarbeiter geführt haben. Die neue Struktur hat erfordert, dass neue Führungskräfte benötigt wurden, die die Mitarbeiter der Chapter führen sollten. Ich habe zu dieser Zeit die Führung des Firmware und Betriebssystem Chapters bekommen, das im Gewerk der Elektronik beheimatet war. Die Aufgabe war es die Firmware (Dieser Begriff ist sehr überladen und wurde in diesem Fall auf das BSP für Mikrocontroller angewendet) und Embedded Betriebssysteme zu betreuen. Dazu gehörten Windows CE und diverse Linux Systeme von Produkten die schon lange ohne Updates des Systems in Serie liefen. Die Chapter, als Sammelpunkt für Fachwissen über die jeweiligen Themengebiete bedienen die Projekte mit den Mitarbeitern, die benötigt werden um die Ziele der Projekte in den geplanten Zeiträumen erreichen zu können. In der Theorie zumindest.

Mein Team bestand aus vier Entwicklern, die aus unterschiedlichen Software Entwicklungsbereichen kamen. Zwei haben seit Jahren Embedded Linux Systeme entwickelt und gepflegt, ein anderer hat hauptsächlich mit Mikrocontrollern gearbeitet, aber viel Erfahrung in der Administration von Linux Systemen. Der vierte kam aus dem Bereich der Softwareentwicklung als Dienstleistung und hat für das Unternehmen bereits als Dienstleister diverse Software und Systeme entwickelt. Alle mit nicht abgeschlossenen Themen von vor der Umstrukturierung, Pflegethemen aus den letzten Jahr(zehnt)en Und ich mitten drin, der Elektroniker, der hier ein Team aufbauen will und noch eine Leiterplatte durch die EMV Messung und Funkzulassung bringen muss.

Drei der vier Teammitglieder kamen aus einer früheren Sparte, der vierte kam aus einer anderen Sparte. Es hat einige Monate gedauert, bis wir im allgemeinen Sprachgebrauch, wenn wir uns über Lösungen und anstehende Herausforderungen unterhalten haben, nicht mehr von „ihr“ und „die“ sondern von wir gesprochen haben. Regelmäßige Termine, bei denen gemeinsam über historische Entscheidungen und Lessons Learned gesprochen haben hat dazu geführt, dass die Sprechart ein Zusammenwachsen vermuten lies. Da die Aufgaben noch sehr geteilt sind, eines der Projekte ist nach wie vor nicht abgeschlossen und bindet einen der Entwickler Vollzeit. Alle anderen arbeiten bereits an einer vereinheitlichten Linux Distribution.

Ein Team von Grund auf aufzubauen ist wie ein Haus zu bauen. Dabei kommt es neben einem stabilen Fundament auch noch auf die stabilen Wände und ein solides Dach an. Das Fundament ist eine gemeinsame Vorstellung wie die technisch richtige Lösung aussehen könnte. Die Wände und das Dach schirmen das Team vom rauen Wetter außerhalb ab, sodass sie sich auf das Fundament konzentrieren können. Doch wie soll das Haus aussehen? Ein Blockhaus aus soliden Baumstämmen? Ein gemauertes Haus aus Ziegelsteinen oder doch lieber ein Zelt, das schnell umgestellt werden kann, wenn der Untergrund nicht die versprochene Stabilität liefert?

In einem neu zusammengestellten Team, vor allem nach einer organisatorischen Änderung, gibt es keine gemeinsamen Prozesse, es werden weiterhin Ergebnisse gefordert, aber welche? Wo beginnt man den Erschaffenden Teil, also die zweite Hälfte der Transformation? Wir haben ein Jahr lang nach bestem Wissen und Gewissen versucht eine Struktur in die Aufgaben und Arbeitspakete zu bringen. Gleichzeitig haben wechselnde Prioritäten zu enormer Unsicherheit geführt. Arbeiten dauerten länger als gedacht, dadurch sind nachfolgende Tätigkeiten später begonnen worden und die Welle an unerledigten Themen wuchs von Woche zu Woche. Das, in Kombination mit Unwissen über die korrekte Verwendung der Softwarewerkzeuge, führte zu einem sehr anstrengenden Jahr. Der Arbeitsvorrat war enorm, unübersichtlich und teilweise Furcht einflößend. Die Ressourcen waren knapp und würden absehbar auch nicht vergrößert. Hinzu kam der organisationspolitische Druck weiterhin umzustrukturieren und alle Code erzeugende Teams im Software-Chapter zusammen zuziehen. Nach monatelangen Diskussionen und Abstimmungen wie welche Aufgabe aufgeteilt wird, haben alle beteiligten eingesehen, dass Vier Personen für die im Chapter anfallenden Themen zu wenig sind. Daher wurde das Chapter aus der Elektronik in die Software umgezogen. Dort standen dann mehr Softwareentwicklungsressourcen in Form von zwei externen Entwicklungsdienstleistern zur Verfügung und wir konnten uns auf die Bearbeitung des Bergs konzentrieren. Neue Projekte, die unsere Unterstützung benötigen kamen ständig dazu und so war es keine Seltenheit, dass eine Person mehrere Hüte auf hatte (oder bis heute noch auf hat).

Ein weiteres Jahr verging und wir haben es geschafft bis zum Ende 2024 genügend Fortschritt zu erreichen, dass es absehbar wurde, dass die Zielerreichung möglich ist. In der Softwareorganisation haben wir begonnen zu investieren. Nicht in noch mehr Programmierer, sondern in Projektmanagement. Wir haben drei Scrum Master ins Unternehmen geholt, die die Projekte dabei unterstützen sollten aus dem, zu diesem Zeitpunk, reaktiven Projektmanagement in ein agil vorausschaues Projektmanagement zu kommen. Eines dieser Projekte war mein eigenes, die allgemein einsetzbare Linux Distribution, die sowohl auf die bereits im Feld befindlichen Systeme als auch auf die neuen Projekte abzielt.

Mit dem Kick-off Ende 2024 haben wir innerhalb von 12 Monaten mehrere Teams mit Hilfe agiler Methoden aus dem reaktivem Entwickeln in strukturiert vorgehende, agil und vorausschauend handelnde Teams verwandelt. Das wichtigste dabei war die klare Kommunikation innerhalb und zwischen den Teams. Das Anwenden vorgegebener agiler Werkzeuge hilft dabei die Rollen klar zu definieren und zu verteilen. Welche Aufgabe hat wer und was wird von den einzelnen im Detail erwartet. Außerdem haben wir Zeit darin investiert die Vision klar zu formulieren und uns alle auf die gemeinsame Vision zu einigen. So ging der Marathon also los. Der Berg an aufgelaufener Arbeit wurde regelmäßig in kleinen Häppchen untersucht, umgedreht und beleuchtet. Was muss wann gemacht werden, was machen wir nicht oder nicht jetzt? Alle diese Fragen wurden für alles was sich in diesem Haufen aufgestaut hat beantwortet. In den ersten Monaten habe ich mich gefühlt wie Sisyphus, jedes mal wenn es so aussah als hätte man etwas erreicht hat sich dahinter nur noch weitere Arbeit verbogen. Nach ungefähr 6 Monaten hat es jedoch deutlich abgenommen und wir haben im Team einen spürbaren und deutlich sichtbaren Fortschritt erreicht. In der Zeit wurden weitere Teams mit Scrum Mastern in die agile Arbeitsweise des Scrums eingeführt und betreut. Der Informationsfluss zwischen den Teams lief über geregelte Kanäle, in Tickets aufgezeichnet um Blockaden sichtbar zu machen und vor allem zivilisiert. In der Zeit ohne klare Kommunikationskanäle hatte jeder die Befürchtung sein Anliegen würde hinter andern zurückstecken müssen, weshalb die Kommunikation immer in Superlativen und mit möglichst vielen hochrangigen Führungskräften in CC geführt wurde.

Eine agile Transformation benötigt Zeit. Die Methoden sind dafür ausgelegt eine konstante hohe Leistung zu ermöglichen, ohne Energie in kurzzeitiger Überbelastung zu verbrennen. Wir haben 6 Monate benötigt, bevor das Gefühl eingetreten ist, dass es wirklich einfacher wird, mit dem Arbeitsvorrat umzugehen. Weitere 6 Monate haben gezeigt, dass andere agile Ansätze, wie das häufige Releasen von Software hilft nachfolgende Teams mit weniger Integrationsaufwand zu belasten. Das hält den Prozess schlank und schlanke Prozesse laufen leichter, was zu einer Mitkopplung führt und so das Arbeiten noch weiter vereinfacht. Die Vorarbeit dafür ist allerdings nicht zu vernachlässigen. Arbeit benötigt Ressourcen, da kommt man auch nicht mit agilen Prozessen drumherum. Agile Methoden lassen Planungsaufwände nicht auf magische Weise verschwinden, sie werden nur über den Projektverlauf verteilt statt zu Beginn auf einmal aufzutreten.

Nachfolgend sind Zusammenfassungen über was bei uns funktioniert hat.

Transparenz schaffen. Über aktive Themen, anstehende Themen, Themen die gerade nicht bearbeitet werden und identifizierte Blockaden und was dagegen unternommen wird; Oder auch nicht unternommen wird.

Klar festgelegte Kommunikationswege zur Kommunikation zwischen Teams. Dabei haben diese Kanäle den Vorteil eventuell weitere Stakeholder hinzuziehen zu können, da sie einen Überblick über die Kommunikation zwischen den Teams haben. Uns hat ein Scrum of Scrums geholfen die Kommunikation und zeitliche Taktung von Arbeitsaufgaben zu koordinieren. Dabei haben sich Vertreter der Scrum Teams regelmäßig getroffen um gemeinsam die nächsten Aufgabenpakete abzustimmen, sodass Abhängigkeiten erkannt und daraus resultierende Aufwände frühzeitig erkannt werden konnten.

Schnelles Releasen. Zu Beginn haben wir ein Release gemacht, wenn wir etwas abgeschlossen hatten. Da mein Team ein Produkt hat, das anderen Teams zuarbeitet kommen für uns Tests mit dem eigentlichen Kunden nicht in Frage. Für unser Produkt sind die Projektteams die Kunden und Kunden wissen nicht was sie wollen. Wenn sie es dann bekommen erkennen sie, dass sie eigentlich was anderes brauchen. Daher so schnell und häufig wie möglich releasen. Dabei ist auch zu achten, dass Funktionen nicht kippen, sondern bestehende Funktionalität erst dann entfernt wird, wenn die nachfolgende Funktionalität getestet und verwendbar ist. Das mach vereinzelt Zusatzaufwände, ist aber langfristig wertvoller, da die neue Funktionalität genutzt werden kann ohne dass es zu Funktionseinschränkung führt.

Ein Team entsteht nicht durch Organigramme, sondern durch Vertrauen und gemeinsame Ziele. Vertrauen muss erarbeitet werden durch gemeinsame Wertschätzung und gemeinsame Arbeit. Jeder im Team hat seine Aufgabe und technische Lösungen haben meistens keinen einzige richtige Lösung. Wenn die Kultur im Team geprägt wird vom Wertschätzen der einzelnen Beiträge, dann kann ein kleines Team großartiges schaffen.

Zeitmanagement zwischen Teamführung und Studium

Wie ich Job, Team und MBA unter einen Hut gebracht habe, oder unter anderthalb Hüte.

Wenn wir mal ehrlich sind, haben wir alle keine Zeit. Arbeit, Freizeitaktivitäten und das Gemeinsame Leben mit Partnern und Kindern nimmt den kompletten Tag in Anspruch. Doch wenn man genau genug hinschaut, findet sich immer Zeit um etwas zu machen, das einem wirklich wichtig ist. Ein Studium neben dem Beruf ist etwas, das viel Zeit die Woche über in Anspruch nimmt. Ich habe im Schnitt ungefähr 12 Stunden pro Wochentag und viele Stunden pro Wochenende aufgebracht. Es waren Wochen dabei bei denen ich weniger geschafft habe und welche in den ich Urlaub hatte, also keine Zeit in das Studium investiert habe. Das ist auch wichtig, denn ohne Pause leidet die Qualität der Arbeit. Es geht nie darum mehr zu machen als andere um besser da zu stehen. Wenn die Qualität mit weniger Stundeneinsatz vergleichbar ist, dann ist es nicht notwendig Stunde um Stunde zu investieren. Es gilt hier ein Maß von gut genug zu finden. Perfektionismus ist der Tod der Zielerreichung. Klar gesetzte, realistische Ziele, die nicht all zu einfach zu erreichen sind waren meine Herangehensweise. Ich habe mir einen Zeitrahmen gesetzte, innerhalb welchem ich mich dem Ziel um ein gewisses Stück genähert habe. Aber was heißt das genau? Ich habe mit beispielsweise ein Kapitel vorgenommen und mir das Ziel gesetzt, den Inhalt innerhalb einer Woche verstanden zu haben und ihn in eigenen Worten ohne Vorlage wiedergeben zu können. Das habe ich manchmal erreicht, manchmal habe ich aber auch ein paar Tage länger gebraucht. Ein anderes Beispiel war es eine Hausarbeit innerhalb von zwei Wochen komplett geschrieben zu haben, unabhängig der Textqualität. Die Nacharbeit der Texte war Inhalt der zweiten und dritten Iteration. Aber so wusste ich zumindest in welche Richtung mich die Arbeit leiten würde, während ich die Struktur finalisiert habe. Dass die Texte darin nicht unbedingt schlüssig, oder in aufbauender Reihenfolge vorkamen war dann das Problem der nächsten Iterationsschleife.

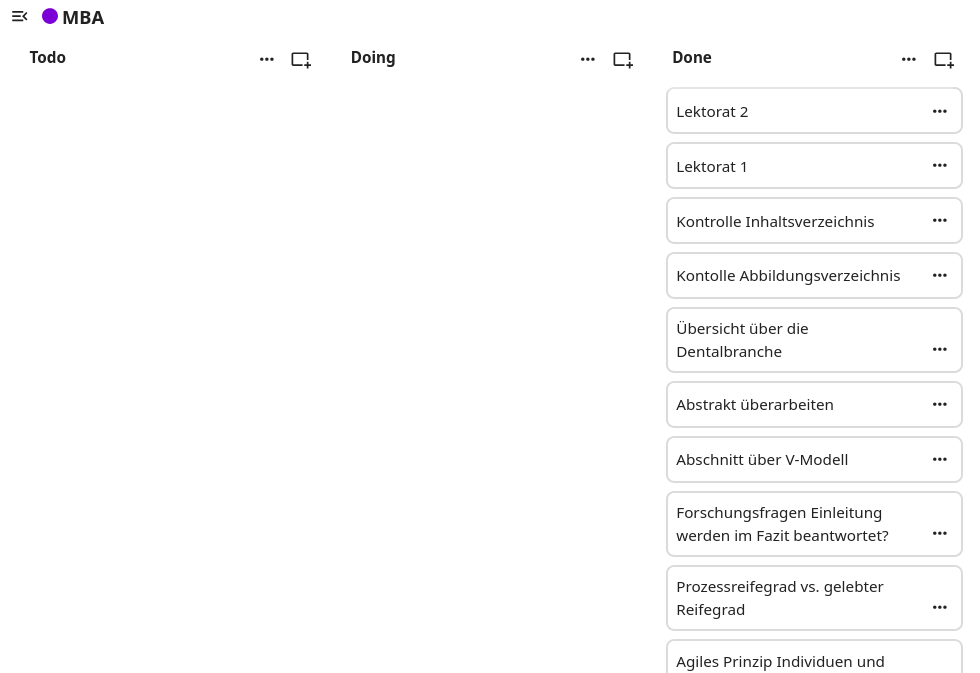
Ich habe meine Arbeiten mit der agile Methode „Kanban“ gesteuert. Für jede Tätigkeit haben ich die notwendige Tätigkeit und die Bedingung, die die Aufgabe als fertig definiert aufgeschrieben. Dazu habe ich in meiner Nextcloud Instanz die Deck App genutzt. Ich habe drei Spalten eingerichtet: Todo, Doing, Done. Dann habe ich darauf geachtet die Aufgabe so zu beschreiben, dass sie vollständig abgeschlossen werden konnte und die „Fertig“ Bedingung erreichen kann ohne, dass sie eine Abhängigkeit zu einer anderen Aufgabe hat. Wenn mir bei der Bearbeitung etwas eingefallen ist, was ich noch benötige, dann habe ich dafür eine neue Karte angelegt. Wenn mich das wirklich bei der Bearbeitung blockiert hat, dann habe ich die Karte zurück nach Todo gelegt und mich um die Vorbedingung gekümmert. Das hat sich am Anfang nach ziemlich viel Overhead angefühlt, aber je mehr ich damit gearbeitet habe, desto besser konnte ich Aufgabenpakete abschätzen, die ich bearbeiten möchte. Die meisten der Karten haben einen Aufwand von mehreren Stunden umfasst, konnten also innerhalb von 1-2 Tagen abgeschlossen werden.

Da kann man aktuell nicht mehr viel erkennen, denn schlussendlich hat es jede Karte nach Done geschafft. Ich habe somit ein Überblick über die noch zu bearbeitenden Themen gehabt und konnte sehen, wie der aktuelle Wasserstand bis zum Ende der jeweiligen Gesamtaufgabe war. Klassisches Kanban, Priorisiertes Backlog, begrenzter Umfang in Progress und Abgeschlossen heißt abgeschlossen. Nacharbeit ist ein neue Arbeitseinheit.

Eine weitere Methode, die ich bereits in „MBA neben dem Job – Warum ich mich dafür entschieden habe“ beschrieben habe ist, Textbücher Absatz für Absatz, handschriftlich zusammen zu fassen und diese Zusammenfassung weiter zusammen zu fassen. Nicht in Stichpunkten, sondern in vollständigen Sätzen. Handschriftlich da ich dadurch zu einem langsameren Schreiben als mit der Tastatur gezwungen wurde. Dadurch konnte ich beim Ausformulieren das Thema intensiver durchdenken, als beim simplen eintippen und während des Schreibens im Satz an den Anfang zurück zu springen um einen unfertigen Satz umzuformulieren.

Ich nutze die Kanban Methode im Arbeitsalltag. Mit physikalisch Post-Its. Handschriftlich beschrieben mit kurzen Sätzen, was neben den in Scrum organisierten Projektthemen in der Rolle des Gruppenleisters noch zu erledigen ist. Ich schreibe auch handschriftliche Zusammenfassungen von Besprechungen, die ich dann als Vorbereitung für Nachfolgende Runden nochmal durchlesen kann.

Zeitmanagement ist kein Luxus, sondern Überlebensstrategie im stressigen Alltag. Wer führen und lernen will, muss bewusst entscheiden, was er nicht tut. Und das bewusste Entscheiden funktioniert nicht, wenn man etwas vergisst, was man eigentlich machen wollte.

Es gibt wohl keine allgemein gültige Lösung um die knappe Zeit die wir haben so effizient wie möglich zu nutzen. Aber probiert aus, was für euch persönlich funktioniert. Mir hat folgendes Videos Denkanstoß geholfen.

Read more