implement #201
Das ist der ganze Prompt. Zwei Wörter, kleingeschrieben, kein Punkt, kein Bitte. Was der Agent wissen muss, steht nicht darin, sondern in Issue #201, das ich vorher mit meinem /create-issue-Skill angelegt habe. Der Prompt ist nur der Zeiger. Die eigentliche Arbeit steckt im Issue.
Im Mai habe ich hier gefragt, wie ihr eigentlich mit euren KI-Agenten redet: kurz und direkt wie ein CLI-Kommando oder ausführlich wie eine Nachricht an einen Kollegen. Jetzt habe ich nachgeschaut, wie ich es selbst mache. Nicht aus dem Bauch heraus, sondern anhand meiner eigenen Historie.
Die Zahlen
Grundlage sind rund 1.270 echte Prompts an Claude Code von Februar bis November 2026, verteilt auf etwa 20 Projekte. 83 % davon habe ich nach 16 Uhr geschrieben. Es geht also vor allem um private Feierabendprojekte.
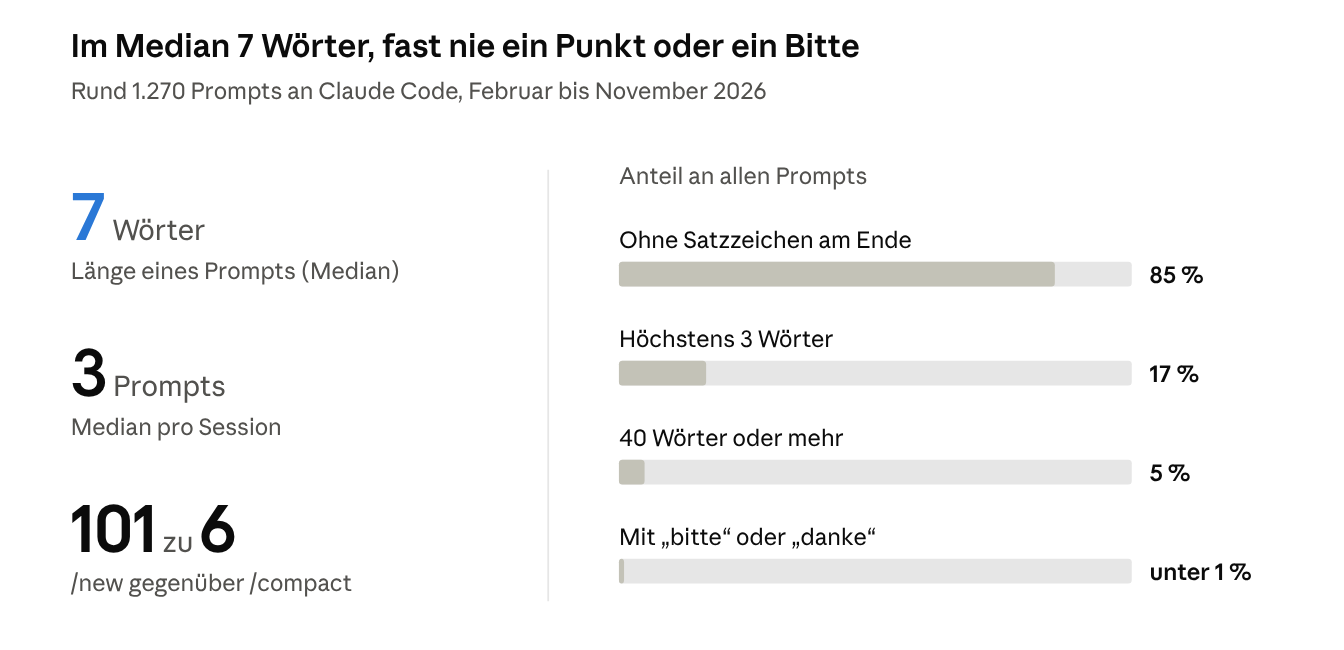
Man könnte meinen, ich sei einfach schreibfaul geworden. Ich sehe das anders: Der Aufwand steckt nicht im Prompt, er passiert vorher. Die Kunst liegt für mich nicht mehr im geschickten Prompt, sondern darin, gute Issues, Skills und Tests einmal zu schreiben. Dann schrumpft der Prompt für die einzelne Aufgabe auf einen Zeiger und ein Verb. Und ich traue dem Agenten Schritt für Schritt mehr zu.
Sechs Muster, die immer wieder auftauchen
Zeiger statt Spezifikation. So sehen viele meiner Prompts aus:
implement #201
fix #179 this is important
Mehr steht da nicht. Die Details liegen im GitHub-Issue. Lang werden meine Prompts nur, wenn ich etwas festlege: eine User Story, einen Plan. Die Umsetzung danach ist fast immer ein Einzeiler. Für mich funktioniert das, weil das Issue einmal ordentlich geschrieben wird, nachlesbar bleibt und für die nächste Session genauso gilt wie für diese.
Teamwork makes the dream work. In 15 % meiner Prompts schreibe ich „we“ oder „let us“. Damit leite ich gemeinsames Arbeiten mit dem Agenten ein, im Chat oder im Interview-Modus, zum Planen und zur Fehlersuche. Auch hier geht es um eine klare Ansage, was passieren soll. Rund 5 % meiner Prompts beginnen mit „plan…“, „look at…“ oder „investigate…“. Manche Themen haben noch so viele Unbekannte, dass ich selbst nicht genau weiß, was ich konkret verlangen soll. Dann soll der Agent zuerst die Fragen herausarbeiten, die sich aus der Aufgabe ergeben:
determine the questions via an interview
Befunde statt Diagnosen. Die langen Prompts sind meistens gar keine langen Anweisungen. Ich kopiere etwas hinein, einen Stacktrace oder eine Warnung aus dem Store, und schreibe einen kurzen Satz davor. Typisch ist so etwas wie:
fix the AuthModal not disappearing: <stack>
Bei Hardware ist es genauso, nur bin ich dann selbst der Stacktrace. Etwa 8,5 % meiner Prompts drehen sich um Geräte, SSH, adb oder Flashen. Dort schreibe ich, was passiert ist und was ich erwartet hätte:
i pushed the button shortly and it turned off. i expected it to switch zoom level
Keine Vermutung, woran es liegen könnte. Mit einer eigenen Diagnose würde ich den Agenten eher in eine Richtung schieben, die vielleicht gar nicht stimmt. Die Beobachtung dagegen kann er nicht selbst machen.
Erst die Tests, damit ich nicht testen muss. So steht es dann auch im Prompt:
start with e2e to not have me doing all the testing
Der Satz erklärt sich fast von selbst. Tests gibt es bei mir vor allem, damit ich nicht nach jeder Änderung alles von Hand durchprobieren muss. Und sie sind die Grundlage für das nächste Muster.
Ketten statt Einzelschritte. 21 % meiner Prompts nennen einen Git- oder Release-Schritt, 52 Prompts reihen sogar drei oder mehr aneinander:
commit, pr, wait for ci, merge and make 0.6.2
Was ich abgebe, ist mit der Zeit mehr geworden. Im Juli hieß es noch „make a PR“. Im August kamen CI, Merge und Tag in einer Kette dazu. Im November dann:
I allow merging, do #415-#419 now and wait for #420
Jede neue Stufe steht auf CI und Tests. Die Freigabe bleibt trotzdem bei mir. Ich spreche sie nur ausdrücklicher aus.
Kurze Sessions, kurze Antworten. Eine Session hat bei mir im Median drei Prompts. 101-mal habe ich /new getippt, sechsmal /compact. Meistens endet eine Session mit Commit, Pull Request, Merge und danach /new. Zwischendurch reichen wenige Worte: Etwa 14 % meiner Prompts sind „yes“, „ok“, „continue“ oder „yes start as proposed“. Ausdrücklich negatives Feedback steht nur in etwa 3 % meiner Prompts. Dann schreibe ich nicht nur „falsch“, sondern beschreibe, wie es sein soll:
this is not what I want. during start, the app shows the icon in fullscreen...
Lange Sessions brauche ich nicht, weil die Regeln nicht im Verlauf stehen, sondern in Skills, in der CLAUDE.md und im Memory. Die gelten in jeder neuen Session wieder.
Damals und heute
Im Mai habe ich zwei Stile gegenübergestellt und wollte beide ausprobieren. Rückblickend war die Frage schief gestellt.
- Damals: kurz oder mit Kontext. Heute: kurz, weil der Kontext schon da ist. Er steht im Issue, im Skill, im Test. Weggefallen ist er nicht, er ist nur umgezogen.
- Damals: „Ich glaube nicht, dass es die eine richtige Art gibt.“ Heute: Das gilt weiterhin. Beim Festlegen wird es lang, beim Umsetzen bleibt es kurz. User Stories sind heute genau die Stelle, an der meine Prompts noch ausführlich werden.
- Damals: Bitte und Danke habe ich als Teil des Kollegen-Stils beschrieben. Heute: Die stehen in weniger als 1 % meiner Prompts.
- Damals: Wir lassen unsere Art, mit den Werkzeugen zu reden, auf dem Stand, auf dem wir sie kennengelernt haben. Heute: Bei mir hat sie sich deutlich verändert, aber nicht durch bessere Formulierungen. Von Februar bis Juni habe ich lange Feature-Beschreibungen geschrieben und oft erst einen Plan verlangt. Im Juli und August kamen Issue-Nummern und Release-Ketten. Im September und Oktober hat Claude echte Geräte geflasht und bedient. Im November habe ich so viel abgegeben wie nie zuvor. Den Beitrag im Mai habe ich also mitten in der Phase der langen Prompts geschrieben.
- Damals: Ich wollte zählen, wie viele Iterationen ich brauche. Heute: drei Prompts pro Session im Median. Ob das an guten Ergebnissen liegt oder daran, dass ich nach jedem Merge neu anfange, verraten die Zahlen nicht.
Wo es hakt und was ich weiter selbst mache
Ein Hinweis ist nur so gut wie das, worauf er zeigt. Ist das Issue dünn, wird „implement #201“ nicht besser, nur schneller.
Drei Dinge bleiben bei mir Handarbeit:
- Die Freigabe zum Mergen. Auch im November schreibe ich ausdrücklich hin, was gemergt werden darf. Das ist für mich keine Formalität, sondern die Stelle, an der die Verantwortung bei mir bleibt. Viele Issues sind so klein, dass die CI die gesamte Funktion abdeckt. Bei größeren Themen behalte ich mir vor, den Schalter selbst umzulegen, nachdem ich das Ergebnis in der Hand hatte.
- Das Testen am echten Gerät. Claude kann flashen und Geräte über adb oder SSH selbst bedienen. Den Knopf drücke aber ich, und ich sehe, was danach passiert.
- Rohdaten herüberholen. Stacktraces und Warnungen aus dem Store kopiere ich von Hand in den Prompt. Da bin ich die Schnittstelle zwischen zwei Systemen, die nichts voneinander wissen.
Noch etwas ist mir aufgefallen: Ich schreibe fast immer Englisch. Deutsch taucht bei Produkttexten auf, bei Betriebsthemen und dann, wenn ich etwas ganz genau erklären will oder genervt bin.
Was ihr morgen ausprobieren könnt
Das sind meine Gewohnheiten, keine Regeln für alle. Wer etwas davon ausprobieren will:
- Schreibt die Anforderung einmal in ein Issue und gebt im Prompt nur noch Nummer und Verb mit, etwa „implement #201“.
- Fügt Fehlermeldungen und Stacktraces ungekürzt ein, statt sie zusammenzufassen. Bei Hardware: was passiert ist und was ihr erwartet habt, ohne eigene Diagnose.
- Lasst zuerst Tests für das schreiben, was ihr sonst von Hand durchklicken würdet. Und prüft die Tests selbst: Wenn neue Tests grün sind, schaut euch das Ergebnis an. Ist es wirklich das, was ihr erwartet habt?
- Gebt den Auftrag in Stufen ab: erst nur den PR, dann PR mit CI, dann Merge mit ausdrücklicher Freigabe.
- Legt Regeln in CLAUDE.md, Skills oder Memory ab und startet für jede Aufgabe eine neue Session.
Und wie sieht das bei euch inzwischen aus?
Was diese Zahlen nicht zeigen
Die Auswertung umfasst nur meine Seite des Gesprächs. Sie sagt nichts darüber, wie gut die Ergebnisse waren, wie viel ich nacharbeiten musste oder ob längere Prompts bessere Ergebnisse gebracht hätten. Dass ich kurz schreibe, heißt erst einmal nur, dass ich kurz schreibe. Eines hat sich trotzdem gezeigt: Mit ein, zwei Sessions nach Feierabend und am Wochenende bekomme ich viel umgesetzt, ohne mein Tokenlimit bei Claude Pro auch nur annähernd auszureizen.